Wan 3.0 對嘴影片
丟一張臉進來,把那句話引起來,嘴就會跟著字走。Wan 3.0 對嘴在跟畫面同一次生成裡把聲音做出來,所以前面不用先錄一個音檔,後面也不用再配一次音。二到三十秒,聲音就在 MP4 裡面,而你的第一支片子不用錢。
阿里巴巴自己的 Wan 3.0 對白展示片 · 按「試試這個」會把提示詞載進來
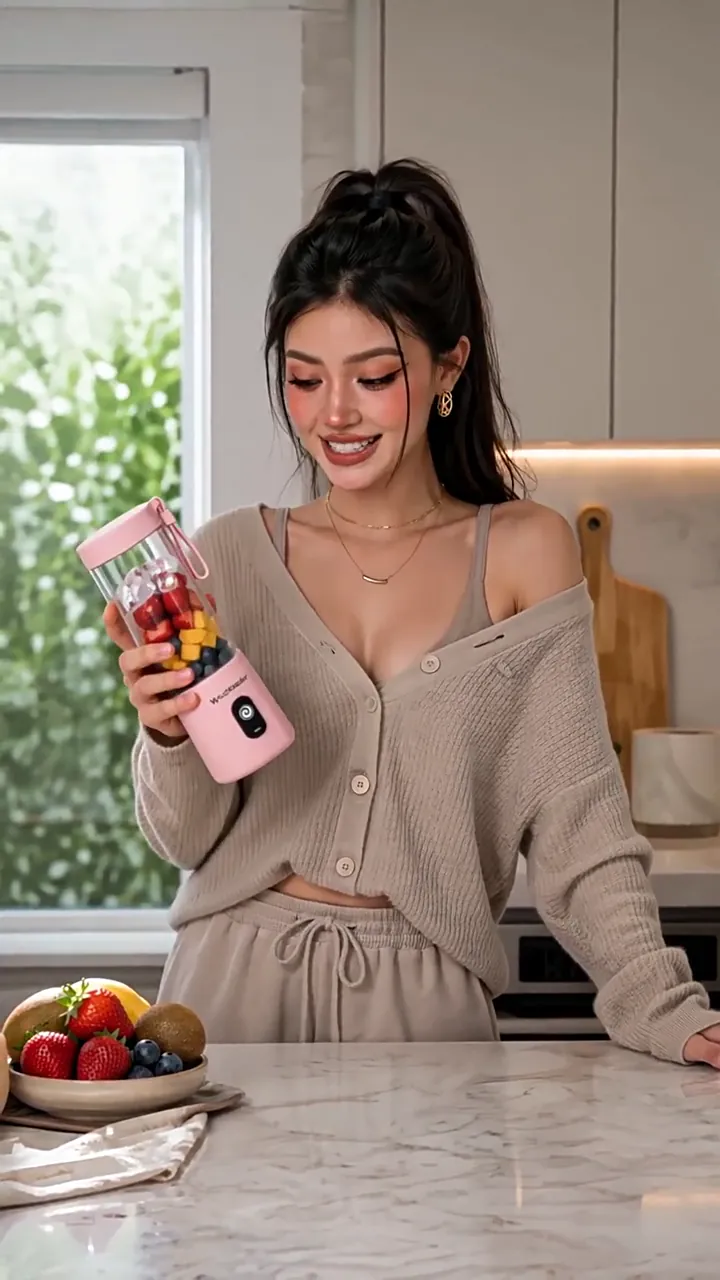
 對鏡頭說話 · 9:16 · 720P
一段對鏡頭的口播,六句話長
當提示詞裡有一句台詞的時候,Wan 3.0 會做什麼
這裡每一支片子都是阿里巴巴為 Wan 3.0 公布的展示片,而每一支都附著產生它的那段提示詞。按聽聽看聽聲音,或者按用這段提示詞把整段載進這一頁最上面那個框裡 — 全文照印,用它原本寫成的那個語言。
- 1 次生成畫面、語音和嘴部動作在同一次生成裡
- $0音軌要另外加的錢
- wan3.0-video這一整條帶子上每一支片子背後的模型
- 參考六句對鏡頭的台詞,產品靠一張參考圖穩住
 參考一位歌手在語言之間切換,八種都對得上
 參考兩個說話的人,日文,一人一句而且不會搶話
 首影格一張兩隻動物的靜態圖變成十輪對話
- 那些字
把確切的那句話引起來。一個轉述換到的是模型自己編的一句話。
- 說話的人
把誰在說話釘死 — 年紀、頭髮、衣著 — 不然動的會是錯的那張嘴。
- 鏡頭
在整句話的長度裡,讓鏡頭留在那張臉上。
- 文字
用不要字幕收尾,不然那句話可能會印在畫面上到達。
用簡單的文字提示詞生出 AI 對嘴影片
沒有腳本格式,沒有時間軸,沒有語音檔。用平常的句子把鏡頭描述出來,把角色說的那些字引起來並指名是鏡頭前的那個人說的,Wan 3.0 就會在單一一個請求裡把畫面算出來、把聲音合成出來,並讓嘴跟著它動。
中景主鏡。那個女人站在廚房檯面後面
拿著那台粉紅色隨行果汁機,自然地對著鏡頭說話。
她說:「常有人問我怎麼可以這麼快就打好一杯果昔。」
不要字幕、不要文字覆蓋、不要介面元素、不要浮水印。
- 鏡頭、運鏡,以及誰在說話
- 被引起來的那句話,以及什麼不要印出來
9:16 · 720P · 30 秒wan3.0-video · 16:9 · 720P · 14 秒 · 語音和嘴型在同一次生成裡
那四行是從阿里巴巴自己那支三十秒展示片裡摘出來的,而那段提示詞寫了 2,484 個字元,上限是 20,000。多出來的空間是拿來釘死說話的人、產品和那些排除項的 — 不是拿來寫更多。改成上傳一張人像而不是描述一張,並不會改變那句台詞本身怎麼寫。
把你的對嘴影片提示詞
用 AI改好
一次跑回來是錯的,幾乎從來不是模型的問題。是一段只指名了畫面、卻把表達方式、鏡頭和字幕規則交給運氣的提示詞。
提示詞產生器會拿你要說的那句話,繞著它回給你一整段 Wan 3.0 提示詞 — 說話的人釘死了、指名了一個運鏡、聲音層次排好了順序,而且那句話被界定起來,所以它會被演出來而不是被旁白唸。它會拿這個模型真正會執行的那些規則去核對結果,所以大家會忘的那一句,是在點數花掉之前補上去的,不是之後。
01
打出你需要被說出來的那句話
一句話就夠開始了。誰說的、在哪裡,可以只是一個片段。
02
拿到一段繞著它蓋起來的提示詞
說話的人、鏡頭、聲音層次和被界定起來的那句話,照 Wan 3.0 讀它們的順序排。
03
把它送到這裡,再加上那張臉
提示詞會到達這一頁最上面那個框裡,長度和比例都已經設好。
已經有一支你喜歡它表達方式的片子?影片轉提示詞會把那句台詞抄下來,用大括號包著還給你 — 那正是這個模型會演出來、而不是旁白唸的那個形式。
一整套 AI 流程,從腳本到影片
同一個端點,四道門。不管你手上拿的是什麼 — 一段腳本、一份簡報、一張人像,或者一支你已經算好的片子 — 都有一條路通到一支說話的片子,而且沒有一條需要外掛另一個語音工具。


上面全部都落在同一個地方 — 我的作品會替每一次生成留著 MP4、提示詞和任務 id,所以一個你喜歡的鏡頭可以重新打開,而不用重新拼回來。
怎麼用 Wan 3.0
讓一張照片對嘴
大家做錯的是第三步:去描述模型本來就看得到的那張畫面,而不是寫下它猜不到的那些字。
把那張臉丟進來
檢查會立刻在你的瀏覽器裡跑。一個好的檔案會亮綠色那一列;一個壞的會在你花任何錢之前把解法指名出來。
檢查不用錢把那句話引起來,並且說是誰說的
把確切的那些字用引號框起來,歸給鏡頭前的那個人。一個轉述 —「她說了一些讓人安心的話」— 換到的是模型自己編的一句話。
只能是確切的字用「不要字幕」收尾
這裡沒有負向提示詞欄位,所以「不要把那句話印出來」就是一句和其他句子一樣的句子。它是一個子句,而它救得了一整次生成。
一個子句設好長度和解析度,然後生成
先把那句話需要的秒數買下來。一個 MP4 會回來,語音、室內音和嘴部動作都已經在裡面。
最高 1080P
一支短片大約九十秒,而它在跑的時候你可以把分頁關掉。上傳的那張照片永遠不會被改動 — 輸出是一個新檔案。
你的照片就是第一個影格。
那個聲音是寫出來的,不是上傳的。
這個類別裡多數工具收一張圖和一個音檔,然後讓嘴去配它。這一個收一張圖和一個句子。

第 001 影格 · 你的臉
從這裡開始,說出來而且對上
Wan 3.0 對嘴把你的照片放進去當字面意義上的第一個影格,然後從它往前生出 2 到 30 秒,30 fps,480P、720P 或 1080P。你引起來的那些字,會以語音的形式回到那支片子自己的音軌裡,而嘴會跟著它動,因為畫面和聲音是在同一次生成裡算出來的,不是分兩次縫起來的。
- 你的照片就是第一個影格
- 001
- 你必須自己提供的音檔
- 0
- 任意整數秒
- 2–30 秒
- 回來一個 MP4,聲音已經在裡面
- 1
你的照片就是第一個影格
你必須自己提供的音檔
任意整數秒
回來一個 MP4,聲音已經在裡面
- 算繪之前不用做文字轉語音
- 算繪之後不用再配一次音
- 不用為那張嘴再授權第二個模型
什麼決定一句話是被說出來
還是被印在畫面上
有兩句話決定一句台詞是被聽到還是被讀到。一句把確切的字放進說話者的嘴裡;另一句把它們擋在畫面外。少了任何一句,那次失敗都會以一支做完、而且已經計費的影片形式到達。
一句對上的台詞的解剖
語音和畫面 · 一次生成
十輪 · 720P · 30 秒那張嘴要站得住需要什麼
3
- 確切的那些字,是引起來的而不是摘要的
- 一個描述到足以釘死的說話者
- 他們講話的時候,鏡頭在他們臉上
大家會漏掉的那一條
這裡沒有負向提示詞欄位,所以「不要印這個」就是提示詞裡一句和其他一樣的句子。少了它,模型就可以自由地把你的對白既當成要說出來的、也當成要畫在畫面上的東西 — 而這正是為什麼上面印出來的、阿里巴巴自己那支三十秒展示片,結尾就是那一句指示。
不要字幕,不要文字覆蓋對負向提示詞:字幕錯
任何長得像負向提示詞的東西,都會被讀成更多要畫出來的字,而請求照樣成功 — 所以那次失敗會以一支做完的片子的形式到達,而畫面某處印著「負向提示詞」這幾個字。
大括號也行 — {like this} 是本站那些提示詞工具吐出來的形式。模型真正在找的,是一句被界定起來、而且附著一個看得見的說話者的台詞,而阿里巴巴自己公布的提示詞用的是引號。文字轉影片講的是那四層聲音,以及該用什麼順序把它們指名出來。
在你花掉一點之前
先檢查那張人像
一張 Wan 3.0 讀不了的臉,是最惱人的一種損失,因為你是在排隊之後才發現,不是之前。把照片丟到這裡,它會對著真正的那些限制被檢查一遍 — 格式、大小、尺寸、比例和透明度 — 而且哪一列沒過,就把那一列的解法指名出來。什麼都沒有上傳:這個檢查跑在你的瀏覽器裡。
JPG · JPEG · PNG · BMP · WEBP · ≤20.0 MB · 240–8,000px · ratio ≤8:1
一張臉,構圖上讓嘴不要是畫面裡最小的東西,能給對嘴最多可以依據的東西。這個檢查器完全不碰模型,所以一張本來就不會被讀到的人像,查清楚它不用花任何錢。
Wan 3.0 對嘴的各項上限
— 人像、片子和聲音
這幾列裡有五列管那張照片,兩列管出來的東西,而最後一列是那條會產生一次沒有人預期的拒收的。這一頁最上面那個上傳框,會在你花任何錢之前先把圖片那幾列檢查過。
一張鎖死的首影格和一段語音錄音不能一起走。 影格是一族輸入,參考是另一族;同時帶著兩者的請求會被直接拒絕,而不是被降級處理,所以這個選擇發生在你上傳之前。
那句台詞本身沒有獨立的欄位,也沒有獨立的上限:它和其他所有東西一起住在提示詞裡,而提示詞裝得下 20,000 個字元。限制一句台詞的是時鐘,不是字數 — 一個短句大約要兩到三秒的畫面時間,所以一句十五個字的台詞放在一支四秒的片子裡,不是被趕就是被切掉。先把那句話需要的秒數買下來,再去買解析度。
一支 Wan 3.0 對嘴的片子要多少錢
長度和解析度決定價格。語音不決定:那個聲音開關改的是回來什麼東西,不是它多少錢,而音色參考完全不計費。失敗的生成會自動退款,而上面那個檢查器一開始就把多數可避免的失敗擋在模型外面。
這是怎麼計費的
- 計費依據
- 每一秒輸出
- 語音、音色參考
- 不收錢
- 你的第一支片子
- 不用錢 · 480P
在 480P 上把那句話打草稿,直到表達方式對了,再花一次生成跑 720P 或 1080P — 兩次生成之間,那張人像不需要重新檢查。完整價格。
兩種繳法,每月點數一樣
Wan 3.0 對嘴 — 大家真的帶著來的那些問題
值得在你上傳一張臉之前先答掉的那些,數字取自阿里巴巴自己的參數表,不是取自一份功能清單。
我需要一個音檔才能對嘴嗎?
She says: "Two minutes to set up." — Wan 3.0 就會自己把語音生出來,在跟畫面同一次生成裡,而且嘴會跟著它動。一張照片加一個句子就是全部的輸入。一段語音錄音是另外那條路,給音色非得是某一個特定的人的時候用。那句台詞要怎麼寫,才會被說出來而不是被描述?
She says: "…",然後是表達方式。只被摘要過的字,會變成旁白或者被模型自己編掉。本站那些提示詞工具會把台詞包在大括號裡,{like this},做的是同一件事:標出那句話從哪裡開始、到哪裡結束。我那句話印在畫面上了,沒有被說出來。為什麼?
Negative prompt: subtitles 會產生相反的效果:那幾個字會變成要畫出來的東西。我可以把照片和語音錄音一起上傳嗎?
那句台詞可以多長?
對嘴支援哪些語言?
同一支片子裡可以有兩個人說話嗎?
語音要另外收錢嗎?
他們講話的時候,畫面其他部分會靜止嗎?
我可以用誰的臉和誰的聲音?
我可以把一支說話的片子拿去商用嗎?
一張臉,一個句子
上傳那張人像,把你需要被說出來的那句話引起來,然後聽聽看回來的是什麼。一支不用錢的 Wan 3.0 片子,480P,最長三秒 — 一個電子郵件,不用卡。如果表達方式不是你想像的那個,它一毛都沒花到你。
由 wan-3.run 編輯團隊撰寫與維護發布於 最後更新 工具 版本 2026.09.4