Wan 3.0 文字轉影片
一句話就夠,三十秒帶聲音
一句提示詞進去,一支成片出來 —— 中間不經過任何剪輯軟體。Wan 3.0 文字轉影片跑 2 到 30 秒,480P、720P 或 1080P,並把對白、音效和音樂寫進和畫面同一個檔案裡。第一支不用錢,而且跑的是真模型,不是去年那個。
六條 Wan 3.0 文字轉影片提示詞和它們產出的片子,後面是範例庫的其餘部分 · 點「試這條」把它裝進來
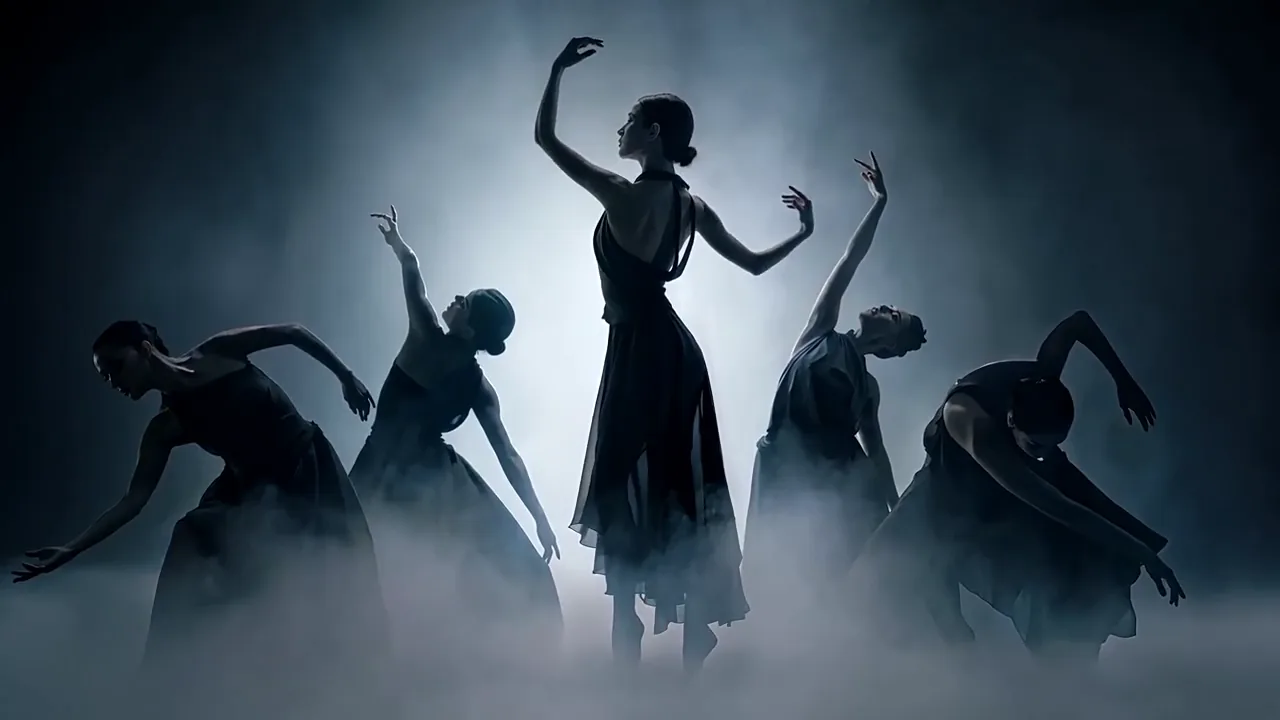
 12 秒 · 16:9 · 720P
逆光霧中的舞者
Wan 3.0 文字轉影片實際給你什麼
Wan 3.0 文字轉影片接受一段最長 20,000 字元的書面提示詞,回傳一個 2 到 30 秒、30 fps 的 MP4,480P、720P 或 1080P,語音、音效和音樂在同一次生成裡產出。沒有單獨的音訊步驟,也沒有放大環節。
一個女人走在街上。
剩下的由模型替你填
- 什麼時候?
- 她穿什麼?
- 光從哪來?
- 鏡頭往哪動?
- 聽起來什麼樣?
- 怎麼收尾?
 Wan 3.0 · 16:9 · 720P · 5 秒
六個你沒給的答案,替你選了。這不是模型不配合 —— 一句提示詞就是一份規格,它留下的每一個開放問題,Wan 3.0 都得自己合上。能不能答得下,就是全部差別所在:20,000 字元遠超任何一個鏡頭需要的量,而聲音的說明就寫在和畫面同一個欄位裡。
- 你能寫的字元數
- 20,000
- 任意整數
- 2–30 秒
- 每一檔都是
- 30 fps
- 解析度:480P · 720P · 1080P
- 3
- 畫面和聲音一起
- 1 次生成
你能寫的字元數
任意整數
每一檔都是
解析度:480P · 720P · 1080P
畫面和聲音一起
- 不用來源圖
- 不用單獨做音訊
- 不用放大環節
五秒和三十秒是
兩種不同的 Wan 3.0 提示詞
這是人們最先搞錯的一件事。一支短的 Wan 3.0 片子要的是把一個動作描述精確。一支長的要的是按順序排好的節拍 —— 而如果你把最後三分之一空著不交代,模型就會拿它喜歡的東西填。下面是三支真片子,一個長度一支,附上做出它的那句提示詞。
5 秒
一個動作
One subject, one action, one framing. Do not describe a change — there is no room to deliver one.
撐得住
把三個節拍寫進五秒,模型自己挑最強的那個。只要一個,你拿到的就是你要的那一個。
12 秒
節拍,按順序
Two or three beats with the order stated. Then, after that, finally — connectives are the only scheduling grammar there is.
收得攏
長到一個形體能進來、停住、再離開。又短到裝不下一個故事 —— 而 Wan 3.0 沒有時間碼語法,所以順序只能靠詞。
15 秒
節拍,外加一個結尾

Give every beat one job and write the last one down. An unplanned final third is the most common way a long clip goes wrong.
落得下
四個節拍,而第四個存在的唯一理由,是讓模型不用自己發明一個停下來的辦法。
區間是 2 到 30 秒,任意整數,一支連續鏡頭。同樣的秒數,在 480P 打草稿只花 1080P 的四分之一,所以先在 480P 把長度找準,解析度只花一次。這幾條提示詞都在提示詞範例裡印全了。
照阿里巴巴自己的公式
搭一句 Wan 3.0 提示詞
把框填上,看著提示詞自己拼起來,再直接送進產生器。
阿里巴巴公布過一句 Wan 3.0 提示詞應該長成什麼形狀:主體,然後場景,然後運動,然後美學控制,然後風格化,聲音寫在旁邊。這個形狀大多數時候會被改寫成散文而消失。這些框把它留住 —— 而且沒有一個欄位名會抵達模型,因為 Wan 3.0 讀的是一整段白話,任何看起來像標籤的東西它都會畫出來。
順序有講究
詞落在哪裡
主體、場景、運動 — 正在發生什麼
畫面裡是誰或是什麼,它在哪兒,什麼在動。
- 主體
- 場景
- 運動
就按這個順序寫,用平白的句子。把主體描述到能在腦子裡成像那麼具體,給這個地方一個時間和一個光源,再說清楚什麼在動、動多遠、多快。靜止也算一個答案 —— 一個你從不提起的鏡頭,是一個模型可以隨便動的鏡頭。
美學控制、風格化 — 怎麼拍
景別、運鏡、鏡頭、光 —— 然後是一個具名的風格,如果這個鏡頭需要的話。
- 美學控制
- 風格化
一串用逗號分開的短句,帶上構圖、運鏡和它的幅度與速度、鏡頭焦段和光。風格化放最後,可選:一個類型片名本身就帶著一整套拍法語法,所以三個字的風格頂得上一整段描述。
聲音 — 同一次生成
對白、音效、環境音、音樂 —— 以及那些靜默。
- 對白
- 音效
- 環境音
- 音樂
Wan 3.0 是把音訊和畫面一起寫出來的,所以這裡是一份聲音說明,不是一件事後補的活。把各層分開點名,把台詞放進大括號裡,並且說清楚你不想聽到什麼 —— 這裡沒有反向提示詞欄位,所以「不要音樂」得寫成一句話。
拼好的提示詞,即時
主體、場景、運動
一個穿著濕透黃色外套的外送員用肩膀頂開一扇門,走進夜裡的窄巷,霓虹灑在濕磚牆上。
美學控制、風格化
中景,鏡頭緩慢推進,小幅度,35mm,淺景深,硬質實用光。
聲音
雨打在布料和柏油上,一聲門軸響,遠處車流。不要音樂。
0 / 20000
這些框是我們組句的順序。標籤本身永遠不會抵達模型。
Wan 3.0 拿它做什麼
- 01一整串白話,最長 20,000 字元
- 02沒有欄位名,沒有鏡頭標記,沒有時間碼
- 03寫成 {確切的那句台詞} 的對白會被演出來
- 04排除項寫成句子,不是一個反向欄位
- 05音訊在同一次生成裡產出,同一個價錢
一個字都不想寫?提示詞產生器能從一句話搭出全部,不用錢,也沒有次數計數器。或者從十一條已經產出過片子的提示詞開始。
把運鏡說出名字,感覺才會來
寫 有電影感 什麼都不會發生 —— 那裡面沒有任何可執行的東西。Wan 3.0 要的是一個動作,而當這個動作帶著幅度和速度時,它跟得緊得多。
push in / pull out / tracking shot / arc shot / tilt up / pan across / static shot
a small move / a large move
slowly / quickly
它這樣動
slowly push in, a small move
有電影感的運鏡
沒有可執行的東西
starts with close-ups, then gently circles both players這是一個序列,不是一張時刻表。「先……然後……」就是全部語法。rising slowly from ground level as the machine stands運鏡掛在動作上,所以它沒法和動作脫節。a slow push in that stops before the centre dancer fills the frame一個帶結束條件而不是時間的運鏡。比另外兩種都穩。
運鏡發生在哪兒
超過你設的長度 —— 模型會壓縮,不會延長
你設的長度在這裡結束
Wan 3.0 沒有時間碼語法。順序來自連接詞 —— 然後、接著、最後 —— 而給一個運鏡排期最可靠的辦法,是把它掛在一個動作上而不是一個時刻上,因為掛在動作上的運鏡會跟著一起壓縮,而不是漸漸失去同步。
已經有素材,比起重寫更想換個風格?那是Wan 3.0 影片剪輯。要讓同一個主體出現在好幾支片子裡?參考圖生影片。
把對白和聲音寫進
一句 Wan 3.0 提示詞
Wan 3.0 在同一個請求裡把音訊和畫面一起生成,這意味著提示詞欄位同時也是聲音說明 —— 而且你寫不寫,價錢一模一樣。什麼都不說,你照樣會拿到一段配樂;只不過那是模型自己挑的。
一句台詞的解剖
同一次生成 · 不另收費
 聲音分三段寫進去 · 720P · 15 秒
四層,各自點名
4
- 對白
- 音效
- 環境音
- 音樂
人們漏掉的那條規則
這裡沒有反向提示詞欄位。排除項要作為句子寫進提示詞裡,而靜默就是其中之一 —— 說「不要音樂」你就得不到音樂,什麼都不說,你就得到模型認為這個場景配得上的東西。
不要音樂,不要旁白對反向提示詞:音樂、旁白錯
任何長得像反向提示詞的東西,都會被當成要畫出來的字,而請求照樣成功 —— 所以這次失敗是以一支把這些字印在裡面的成片的形式抵達的。
從說話人的照片出發?對嘴在同一套寫法前面擺了一個上傳框。要在好幾支片子裡保住同一張臉或同一個聲音?用參考圖生影片 —— 它一個請求能帶十張圖、五段影片和五段音訊。
Wan 3.0 文字轉影片的參數,
和四個坑
這些坑裡有兩個第一次踩就要花錢:解析度不設,就預設落在最貴的那一檔,而畫面比例缺了會讓請求直接失敗。其餘的是阿里巴巴公布的 Wan 3.0 數字,每一個都連到出處。


- 01提示詞長度
- 20,000 字元超長的輸入是靜默截斷,不是被拒
- 長度
- 2–30 秒,整秒一次生成。超過三十秒就意味著第二支片子加一套剪輯軟體
- 影格率
- 30 fps
- 02解析度
- 480P · 720P · 1080P不設時預設 1080P —— 請明確指定
- 4K
- 不支援
- 畫面比例
- 自適應、16:9、4:3、1:1、3:4、9:16文字轉影片需要一個具體比例 —— 自適應沒有圖可以讀出比例
- 音訊
- 在同一次生成裡產出開或關,價格完全相同
- 隨機種子
- 0–2,147,483,647固定住大部分變化,不是全部
Source: 阿里雲百鍊 · Wan 3.0 文字轉影片的 API 文件
最容易把人絆倒的四件事
- 01
解析度預設落在最貴的那一檔。
- 480P
- 720P
- 1080P
- unset
不寫它,Wan 3.0 就按 1080P 生成 —— 也按 1080P 計費。先在 480P 打草稿,同樣的秒數只要四分之一的錢,等留下來的那支再把解析度花掉一次。
- 02
這裡沒有反向提示詞欄位。
- 不要音樂
- 不要畫面上的字
- 不要手持晃動
- negative_prompt
排除項要作為句子寫進提示詞裡。任何按反向提示詞格式寫的東西,都會作為要畫出來的字抵達,而請求照樣回傳 200 —— 所以你花錢買到一支把這些字印在裡面的片子。
- 03
參考素材的編號區分大小寫。
- Image 1
- Video 1
- Audio 1
- image1
首字母大寫,中間一個空格,按上傳順序在各自類型裡編號。小寫和底線綁不到任何東西上,模型會悄悄自己編一個主體出來。更多寫在參考圖生影片裡。
- 04
智慧長度會把價錢藏起來。
- 3s
- 5s
- 15s
- 30s
- auto
把長度交給模型決定,意味著在它跑完之前成本都是未知的。我們改為按一個明確長度計費,所以按鈕上的那個數就是最後扣掉的那個數。
一支 Wan 3.0 文字轉影片的片子要多少錢
點數是在片子回來時扣的,不是在你按下生成時扣的。失敗的生成不扣錢,自動退回,不用開客服單。只有長度和解析度會動這筆帳 —— 音訊不會,畫面比例不會,你在哪個方案上也不會。
一支 5 秒的片子,按點數算
- 480P
- 40 點
- 720P
- 80 點
- 1080P
- 160 點
每一檔翻一倍,而 Wan 3.0 從第一秒起就計量,沒有免費的地板,所以一支 15 秒的片子是它旁邊那支 5 秒的三倍。實用的循環是:先在 480P 把鏡頭找準,再讓留下來的那支在 1080P 上跑一次。完整點數表,以及一支三十秒的片子要多少錢。
兩種繳法,每月點數一樣
Wan 3.0 文字轉影片三步走
三步,不用剪輯軟體,音訊也不用跑第二遍。它就在和畫面同一個檔案裡,因為 Wan 3.0 是把它們一起做出來的。
把鏡頭和聲音寫出來
一個欄位兩樣都收。如果問題是那個空白框,就用上面的搭建器,而且請點名一個運鏡,不要去搆形容詞 —— 模型回應的是動作,不是情緒。
最長 20,000 字元設長度和解析度
二到三十的整秒。先在 480P 打草稿:你要試的那個構圖不需要更多,而且每一檔都是同一個 Wan 3.0 —— 解析度買的是像素,不是一個更好的模型。
2–30 秒 · 480P / 720P / 1080P下載 MP4
音訊已經混進去了。事後沒有要算繪的東西,也沒有要打開的東西。
一個檔案,含聲音
短片子大約九十秒;1080P 的三十秒要更久。跑的時候你可以關掉分頁 —— 回來時結果在等著,而失敗的那一次會自己退錢。
Wan 3.0 文字轉影片常見問題
Wan 3.0 文字轉影片從提示詞裡讀什麼,在你留空的地方它會編什麼,以及跑一次要多少錢
什麼是 Wan 3.0 文字轉影片?
試 Wan 3.0 文字轉影片要註冊嗎?
一支 Wan 3.0 文字轉影片的片子能多長?
一句 Wan 3.0 提示詞能多長?
Wan 3.0 文字轉影片會生成聲音嗎?
Wan 3.0 有反向提示詞嗎?
對白怎麼寫?
Wan 3.0 文字轉影片能出 4K 嗎?
為什麼我的片子把提示詞的一部分忽略了?
生成失敗了會怎樣?
一句話就夠,試一次就知道。
第一支算我們的 —— Wan 3.0 本體,480P,最長三秒,帶聲音。不是你想的那樣?它沒花你的錢,搭建器還在上面一屏開著,而且失敗的生成在這裡從來不計費。
由 wan-3.run 編輯團隊撰寫與維護發布於 最後更新 工具 版本 2026.09.4