Wan 3.0 文生视频
三十秒,声音一起给
一句提示词进去,一条成片出来 —— 中间不经过任何剪辑软件。Wan 3.0 文生视频跑 2 到 30 秒,480P、720P 或 1080P,并把对白、音效和音乐写进和画面同一个文件里。第一条不要钱,而且跑的是真模型,不是去年那个。
六条 Wan 3.0 文生视频提示词和它们产出的片子,后面是范例库的其余部分 · 点「试这条」把它装进来
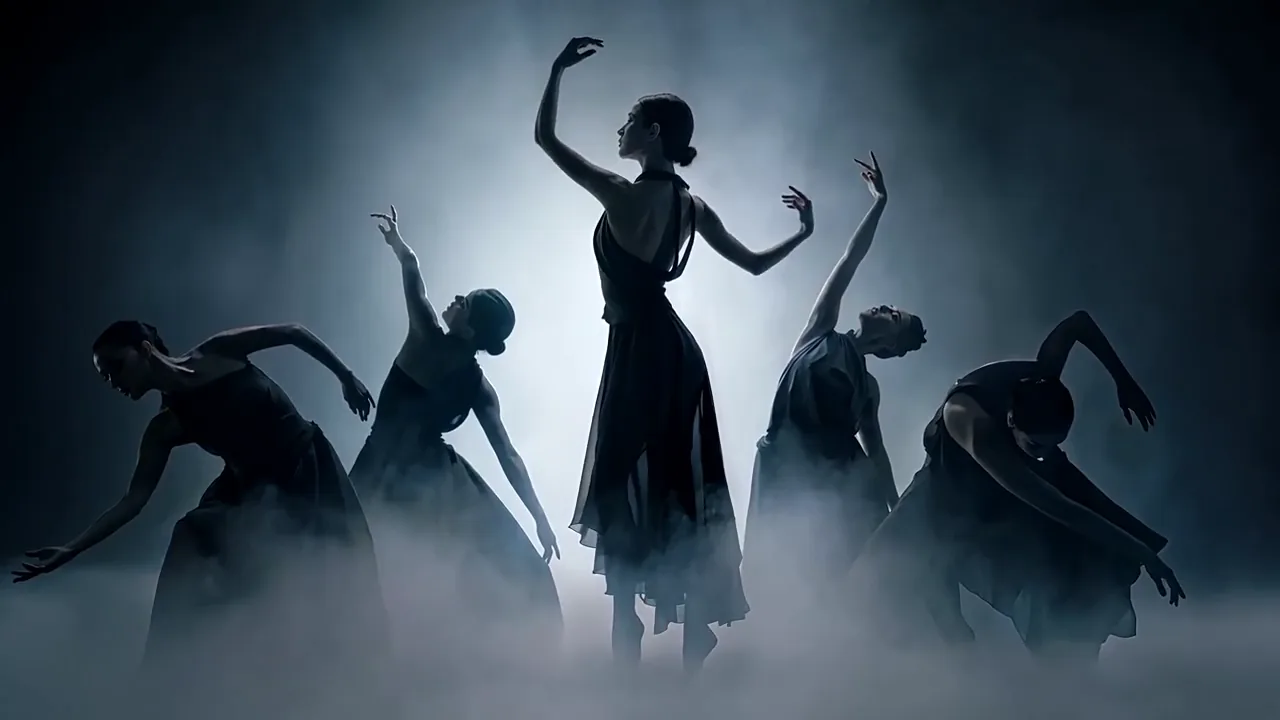
 12 秒 · 16:9 · 720P
逆光雾中的舞者
Wan 3.0 文生视频实际给你什么
Wan 3.0 文生视频接受一段最长 20,000 字符的书面提示词,返回一个 2 到 30 秒、30 fps 的 MP4,480P、720P 或 1080P,语音、音效和音乐在同一次生成里产出。没有单独的音频步骤,也没有放大环节。
一个女人走在街上。
剩下的由模型替你填
- 什么时候?
- 她穿什么?
- 光从哪来?
- 镜头往哪动?
- 听起来什么样?
- 怎么收尾?
 Wan 3.0 · 16:9 · 720P · 5 秒
六个你没给的答案,替你选了。这不是模型不配合 —— 一句提示词就是一份规格,它留下的每一个开放问题,Wan 3.0 都得自己合上。能不能答得下,就是全部差别所在:20,000 字符远超任何一个镜头需要的量,而声音的说明就写在和画面同一个字段里。
- 你能写的字符数
- 20,000
- 任意整数
- 2–30 秒
- 每一档都是
- 30 fps
- 分辨率:480P · 720P · 1080P
- 3
- 画面和声音一起
- 1 次生成
你能写的字符数
任意整数
每一档都是
分辨率:480P · 720P · 1080P
画面和声音一起
- 不用源图
- 不用单独做音频
- 不用放大环节
五秒和三十秒是
两种不同的 Wan 3.0 提示词
这是人们最先搞错的一件事。一条短的 Wan 3.0 片子要的是把一个动作描述精确。一条长的要的是按顺序排好的节拍 —— 而如果你把最后三分之一空着不交代,模型就会拿它喜欢的东西填。下面是三条真片子,一个长度一条,附上做出它的那句提示词。
5 秒
一个动作
One subject, one action, one framing. Do not describe a change — there is no room to deliver one.
撑得住
把三个节拍写进五秒,模型自己挑最强的那个。只要一个,你拿到的就是你要的那一个。
12 秒
节拍,按顺序
Two or three beats with the order stated. Then, after that, finally — connectives are the only scheduling grammar there is.
收得拢
长到一个形态能进来、停住、再离开。又短到装不下一个故事 —— 而 Wan 3.0 没有时间码语法,所以顺序只能靠词。
15 秒
节拍,外加一个结尾

Give every beat one job and write the last one down. An unplanned final third is the most common way a long clip goes wrong.
落得下
四个节拍,而第四个存在的唯一理由,是让模型不用自己发明一个停下来的办法。
区间是 2 到 30 秒,任意整数,一条连续镜头。同样的秒数,在 480P 打草稿只花 1080P 的四分之一,所以先在 480P 把长度找准,分辨率只花一次。这几条提示词都在提示词范例里印全了。
按阿里巴巴自己的公式
搭一句 Wan 3.0 提示词
把框填上,看着提示词自己拼起来,再直接送进生成器。
阿里巴巴公布过一句 Wan 3.0 提示词应该长成什么形状:主体,然后场景,然后运动,然后美学控制,然后风格化,声音写在旁边。这个形状大多数时候会被改写成散文而消失。这些框把它留住 —— 而且没有一个字段名会到达模型,因为 Wan 3.0 读的是一整段白话,任何看起来像标签的东西它都会画出来。
顺序有讲究
词落在哪里
主体、场景、运动 — 正在发生什么
画面里是谁或是什么,它在哪儿,什么在动。
- 主体
- 场景
- 运动
就按这个顺序写,用平白的句子。把主体描述到能在脑子里成像那么具体,给这个地方一个时间和一个光源,再说清楚什么在动、动多远、多快。静止也算一个答案 —— 一个你从不提起的镜头,是一个模型可以随便动的镜头。
美学控制、风格化 — 怎么拍
景别、运镜、镜头、光 —— 然后是一个具名的风格,如果这个镜头需要的话。
- 美学控制
- 风格化
一串用逗号分开的短句,带上构图、运镜和它的幅度与速度、镜头焦段和光。风格化放最后,可选:一个类型片名本身就带着一整套拍法语法,所以三个字的风格顶得上一整段描述。
声音 — 同一次生成
对白、音效、环境声、音乐 —— 以及那些静默。
- 对白
- 音效
- 环境声
- 音乐
Wan 3.0 是把音频和画面一起写出来的,所以这里是一份声音说明,不是一件事后补的活。把各层分开点名,把台词放进大括号里,并且说清楚你不想听到什么 —— 这里没有反向提示词字段,所以「不要音乐」得写成一句话。
拼好的提示词,实时
主体、场景、运动
一个穿着湿透黄色外套的快递员用肩膀顶开一扇门,走进夜里的窄巷,霓虹洒在湿砖墙上。
美学控制、风格化
中景,镜头缓慢推进,小幅度,35mm,浅景深,硬质实用光。
声音
雨打在布料和沥青上,一声门轴响,远处车流。不要音乐。
0 / 20000
这些框是我们组句的顺序。标签本身永远不会到达模型。
Wan 3.0 拿它做什么
- 01一整串白话,最长 20,000 字符
- 02没有字段名,没有镜头标记,没有时间码
- 03写成 {确切的那句台词} 的对白会被演出来
- 04排除项写成句子,不是一个反向字段
- 05音频在同一次生成里产出,同一个价钱
一个字都不想写?提示词生成器能从一句话搭出全部,不要钱,也没有次数计数器。或者从十一条已经产出过片子的提示词开始。
把运镜说出名字,感觉才会来
写 有电影感 什么都不会发生 —— 那里面没有任何可执行的东西。Wan 3.0 要的是一个动作,而当这个动作带着幅度和速度时,它跟得紧得多。
push in / pull out / tracking shot / arc shot / tilt up / pan across / static shot
a small move / a large move
slowly / quickly
它这样动
slowly push in, a small move
有电影感的运镜
没有可执行的东西
starts with close-ups, then gently circles both players这是一个序列,不是一张时刻表。「先……然后……」就是全部语法。rising slowly from ground level as the machine stands运镜挂在动作上,所以它没法和动作脱节。a slow push in that stops before the centre dancer fills the frame一个带结束条件而不是时间的运镜。比另外两种都稳。
运镜发生在哪儿
超过你设的时长 —— 模型会压缩,不会延长
你设的时长在这里结束
Wan 3.0 没有时间码语法。顺序来自连接词 —— 然后、接着、最后 —— 而给一个运镜排期最可靠的办法,是把它挂在一个动作上而不是一个时刻上,因为挂在动作上的运镜会跟着一起压缩,而不是渐渐失去同步。
已经有素材,比起重写更想换个风格?那是Wan 3.0 视频剪辑。要让同一个主体出现在好几条片子里?参考生视频。
把对白和声音写进
一句 Wan 3.0 提示词
Wan 3.0 在同一个请求里把音频和画面一起生成,这意味着提示词字段同时也是声音说明 —— 而且你写不写,价钱一模一样。什么都不说,你照样会拿到一条配乐;只不过那是模型自己挑的。
一句台词的解剖
同一次生成 · 不另收费
 声音分三段写进去 · 720P · 15 秒
四层,各自点名
4
- 对白
- 音效
- 环境声
- 音乐
人们漏掉的那条规则
这里没有反向提示词字段。排除项要作为句子写进提示词里,而静默就是其中之一 —— 说「不要音乐」你就得不到音乐,什么都不说,你就得到模型认为这个场景配得上的东西。
不要音乐,不要旁白对反向提示词:音乐、旁白错
任何长得像反向提示词的东西,都会被当成要画出来的字,而请求照样成功 —— 所以这次失败是以一条把这些字印在里面的成片的形式到达的。
从说话人的照片出发?对口型在同一套写法前面摆了一个上传框。要在好几条片子里保住同一张脸或同一个声音?用参考生视频 —— 它一个请求能带十张图、五段视频和五段音频。
Wan 3.0 文生视频的参数,
和四个坑
这些坑里有两个第一次踩就要花钱:分辨率不设,就默认落在最贵的那一档,而画面比例缺了会让请求直接失败。其余的是阿里巴巴公布的 Wan 3.0 数字,每一个都链到出处。


- 01提示词长度
- 20,000 字符超长的输入是静默截断,不是被拒
- 时长
- 2–30 秒,整秒一次生成。超过三十秒就意味着第二条片子加一个剪辑软件
- 帧率
- 30 fps
- 02分辨率
- 480P · 720P · 1080P不设时默认 1080P —— 请显式指定
- 4K
- 不支持
- 画面比例
- 自适应、16:9、4:3、1:1、3:4、9:16文生视频需要一个具体比例 —— 自适应没有图可以读出比例
- 音频
- 在同一次生成里产出开或关,价格完全相同
- 随机种子
- 0–2,147,483,647固定住大部分变化,不是全部
Source: 阿里云百炼 · Wan 3.0 文生视频接口文档
最容易把人绊倒的四件事
- 01
分辨率默认落在最贵的那一档。
- 480P
- 720P
- 1080P
- unset
不写它,Wan 3.0 就按 1080P 生成 —— 也按 1080P 计费。先在 480P 打草稿,同样的秒数只要四分之一的钱,等留下来的那条再把分辨率花掉一次。
- 02
这里没有反向提示词字段。
- 不要音乐
- 不要画面上的字
- 不要手持抖动
- negative_prompt
排除项要作为句子写进提示词里。任何按反向提示词格式写的东西,都会作为要画出来的字到达,而请求照样返回 200 —— 所以你花钱买到一条把这些字印在里面的片子。
- 03
参考素材的编号区分大小写。
- Image 1
- Video 1
- Audio 1
- image1
首字母大写,中间一个空格,按上传顺序在各自类型里编号。小写和下划线绑不到任何东西上,模型会悄悄自己编一个主体出来。更多写在参考生视频里。
- 04
智能时长会把价钱藏起来。
- 3s
- 5s
- 15s
- 30s
- auto
把长度交给模型决定,意味着在它跑完之前成本都是未知的。我们改为按一个显式时长计费,所以按钮上的那个数就是最后扣掉的那个数。
一条 Wan 3.0 文生视频的片子要多少钱
积分是在片子回来时扣的,不是在你按下生成时扣的。失败的生成不扣钱,自动退回,不用开工单。只有长度和分辨率会动这笔账 —— 音频不会,画面比例不会,你在哪个套餐上也不会。
一条 5 秒的片子,按积分算
- 480P
- 40 积分
- 720P
- 80 积分
- 1080P
- 160 积分
每一档翻一倍,而 Wan 3.0 从第一秒起就计量,没有免费的地板,所以一条 15 秒的片子是它旁边那条 5 秒的三倍。实用的循环是:先在 480P 把镜头找准,再让留下来的那条在 1080P 上跑一次。完整积分表,以及一条三十秒的片子要多少钱。
两种付法,每月积分一样
Wan 3.0 文生视频三步走
三步,不用剪辑软件,音频也不用跑第二遍。它就在和画面同一个文件里,因为 Wan 3.0 是把它们一起做出来的。
把镜头和声音写出来
一个字段两样都收。如果问题是那个空白框,就用上面的搭建器,而且请点名一个运镜,不要去够形容词 —— 模型响应的是动作,不是情绪。
最长 20,000 字符设长度和分辨率
二到三十的整秒。先在 480P 打草稿:你要试的那个构图不需要更多,而且每一档都是同一个 Wan 3.0 —— 分辨率买的是像素,不是一个更好的模型。
2–30 秒 · 480P / 720P / 1080P下载 MP4
音频已经混进去了。事后没有要渲染的东西,也没有要打开的东西。
一个文件,含声音
短片子大约九十秒;1080P 的三十秒要更久。跑的时候你可以关掉标签页 —— 回来时结果在等着,而失败的那一次会自己退钱。
Wan 3.0 文生视频常见问题
Wan 3.0 文生视频从提示词里读什么,在你留空的地方它会编什么,以及跑一次要多少钱
什么是 Wan 3.0 文生视频?
试 Wan 3.0 文生视频要注册吗?
一条 Wan 3.0 文生视频的片子能多长?
一句 Wan 3.0 提示词能多长?
Wan 3.0 文生视频会生成声音吗?
Wan 3.0 有反向提示词吗?
对白怎么写?
Wan 3.0 文生视频能出 4K 吗?
为什么我的片子把提示词的一部分忽略了?
生成失败了会怎样?
一句话就够,试一次就知道。
第一条算我们的 —— Wan 3.0 本体,480P,最长三秒,带声音。不是你想的那样?它没花你的钱,搭建器还在上面一屏开着,而且失败的生成在这里从来不计费。
由 wan-3.run 编辑团队撰写与维护发布于 最后更新 工具 版本 2026.09.4