Wan 3.0 Lippensynchronisation
Leg ein Gesicht hinein, zitier die Zeile, und der Mund folgt den Worten. KI-Lippensynchronisation mit Wan 3.0 generiert die Stimme im selben Durchlauf wie das Bild — es gibt keine Audiodatei, die vorher aufgenommen werden müsste, und keinen Synchronisationsdurchgang danach. Zwei bis dreißig Sekunden, Ton in der MP4, und dein erster Clip ist kostenlos.
Alibabas eigene Wan-3.0-Dialogdemos · „Ausprobieren“ lädt den Prompt
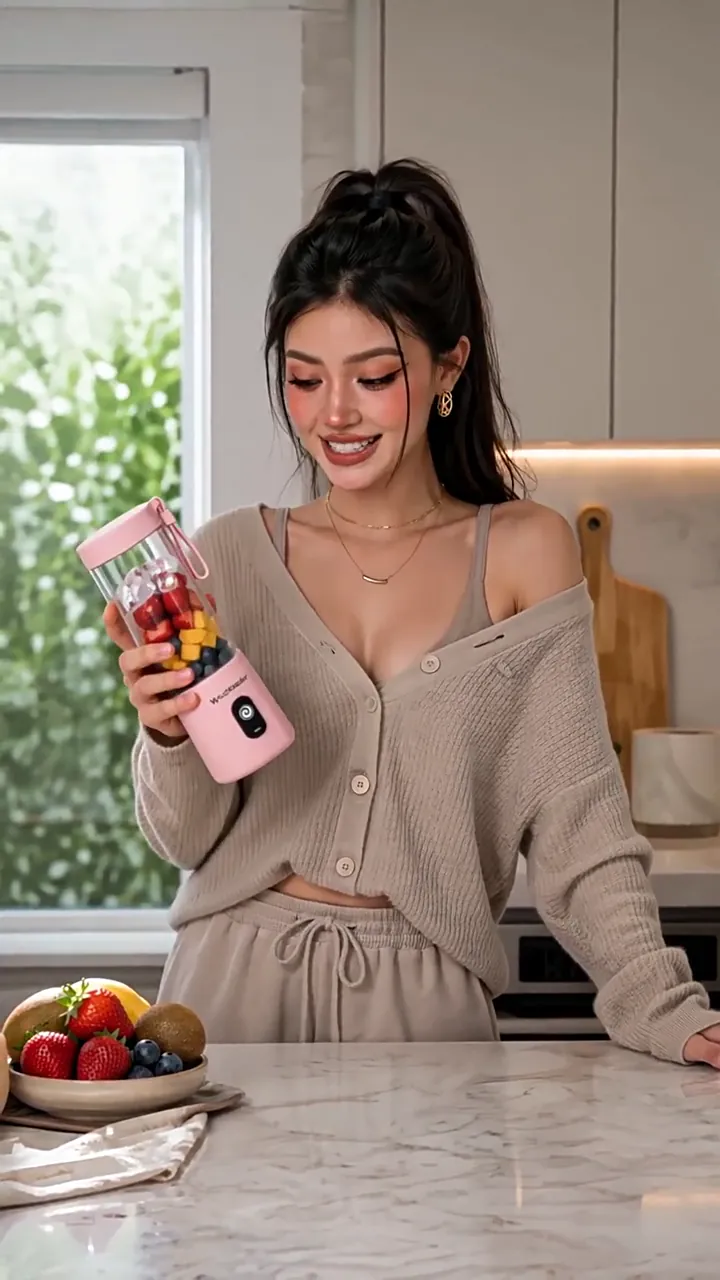
 IN DIE KAMERA GESPROCHEN · 9:16 · 720P
Ein Stück in die Kamera, sechs Zeilen lang
Was Wan 3.0 macht, wenn im Prompt eine Zeile steht
Jeder Clip hier ist eine Demo, die Alibaba für Wan 3.0 veröffentlicht hat, und zu jeder gab es den Prompt, aus dem sie entstand. Drück Anhören für die Stimme oder Prompt verwenden, um das Ganze in das Feld oben auf dieser Seite zu laden — in voller Länge abgedruckt, in der Sprache, in der er geschrieben wurde.
- 1 DurchlaufBild, Sprache und Mundbewegung in einer Generierung
- $0Aufpreis für die Tonspur
- wan3.0-videodas Modell hinter jedem Clip in dieser Reihe
- ReferenzSechs Zeilen in die Kamera, das Produkt an ein Referenzbild gebunden
 ReferenzEine Sängerin wechselt die Sprache, die Synchronität hält durch alle acht
 ReferenzZwei Sprecher, Japanisch, je eine Zeile und kein Durcheinander
 Erster FrameAus einem Standbild zweier Tiere werden zehn Runden Dialog
- Die Worte
Zitier die genaue Zeile. Eine Umschreibung bekommt eine Zeile, die das Modell erfunden hat.
- Sprecher
Leg fest, wer spricht — Alter, Haare, Kleidung — sonst bewegt sich der falsche Mund.
- Kamera
Halt sie auf dem Gesicht, solange die Zeile läuft.
- Text
Schließ mit no subtitles, sonst kann die Zeile im Bild gedruckt ankommen.
KI-Lippensynchronisation aus einfachen Text-Prompts
Kein Skriptformat, keine Zeitleiste, keine Sprachdatei. Beschreib die Einstellung in gewöhnlichen Sätzen, zitier die Worte, die die Figur sagt, und ordne sie der Person vor der Kamera zu — Wan 3.0 rendert das Bild, synthetisiert die Stimme und bewegt den Mund dazu, in einer einzigen Anfrage.
Medium A-roll. The woman stands behind the kitchen counter
holding the pink portable blender, speaking naturally to camera.
She says: "I get asked how I make smoothies so quickly."
No subtitles, no text overlays, no UI, no watermark.
- Einstellung, Kamera und wer spricht
- Die zitierte Zeile und was nicht gedruckt werden darf
9:16 · 720P · 30Swan3.0-video · 16:9 · 720P · 14 s · Sprache und Mund im selben Durchlauf
Diese vier Zeilen stammen aus Alibabas eigener Dreißig-Sekunden-Demo, die auf 2.484 Zeichen kommt — bei einer Obergrenze von 20.000. Sie stehen hier unübersetzt, weil sie ein Zitat sind, und weil Wan 3.0 Prompts auf Englisch und Chinesisch garantiert: Die Struktursätze bleiben englisch, dein eigener Inhalt darf deutsch sein. Der Platz ist da, um Sprecher, Produkt und Ausschlüsse festzunageln, nicht um mehr zu schreiben. Ob du ein Porträt hochlädst oder eines beschreibst, ändert an der Zeile selbst nichts.
Verbessere deinen Lipsync-Prompt
mit KI
Ein Durchlauf, der falsch zurückkommt, ist fast nie ein Problem des Modells. Es ist ein Prompt, der das Bild benannt und die Sprechweise, die Kamera und die Untertitelregel dem Zufall überlassen hat.
Der Prompt-Generator nimmt die Zeile, die gesagt werden soll, und gibt einen vollständigen Wan-3.0-Prompt darum herum zurück — Sprecher festgelegt, eine Kamerabewegung benannt, die Tonebenen geordnet und die Zeile abgegrenzt, damit sie gesprochen und nicht erzählt wird. Er prüft das Ergebnis gegen die Regeln, die dieses Modell wirklich durchsetzt, sodass der Satz, den alle vergessen, hinzukommt, bevor der Credit ausgegeben ist, und nicht danach.
01
Tipp die Zeile ein, die gesagt werden soll
Ein Satz reicht zum Anfangen. Wer sie sagt und wo, darf ein Fragment sein.
02
Bekomm einen Prompt, der darum herum gebaut ist
Sprecher, Kamera, Tonebenen und die abgegrenzte Zeile, in der Reihenfolge, in der Wan 3.0 sie liest.
03
Schick ihn hierher und füg das Gesicht dazu
Der Prompt landet im Feld oben auf dieser Seite, Länge und Verhältnis schon gesetzt.
Du schreibst die Zeile für eine bezahlte Anzeige statt für ein Stück in die Kamera? Der UGC-Werbevideo-Generator hat die Wortzahl, die fünfzehn Sekunden wirklich tragen, und die Kennzeichnungsregeln, die darüber entscheiden, ob sie läuft.
Du hast schon einen Clip, dessen Sprechweise dir gefiel? Video zu Prompt transkribiert die gesprochene Zeile und gibt sie in geschweiften Klammern zurück — in der Form, die dieses Modell spricht statt erzählt.
Ein vollständiger KI-Ablauf, vom Skript zum Video
Vier Türen zum selben Endpunkt. Was auch immer du in der Hand hast — einen Absatz Skript, ein Deck, ein Porträt oder einen Clip, den du schon gerendert hast — es gibt einen Weg davon zu einer sprechenden Einstellung, und keiner davon braucht ein angeschraubtes Sprachwerkzeug.


Alles oben landet an derselben Stelle — Meine Werke behält die MP4, den Prompt und die Task-ID für jeden Durchlauf, eine Einstellung, die dir gefiel, lässt sich also wieder öffnen statt rekonstruieren.
Ein Foto lippensynchron sprechen lassen
mit Wan 3.0
Der Schritt, den Leute falsch machen, ist der dritte: das Bild zu beschreiben, das das Modell schon sieht, statt die Worte zu schreiben, die es nicht erraten kann.
Leg das Gesicht hinein
Die Prüfung läuft sofort, in deinem Browser. Eine gute Datei zeigt eine grüne Zeile; eine schlechte benennt die Lösung, bevor du etwas ausgibst.
Kostenlos geprüftZitier die Zeile und sag, wer sie sagt
Die genauen Worte in Anführungszeichen, der Person vor der Kamera zugeordnet. Eine Umschreibung — „sie sagt etwas Beruhigendes“ — bringt dir eine Zeile, die das Modell erfunden hat.
Nur genaue WorteSchließ mit „no subtitles“
Es gibt kein Feld für Negativ-Prompts, die Anweisung, die Zeile nicht zu drucken, ist also ein Satz wie jeder andere. Es ist ein Nebensatz, und er rettet einen ganzen Durchlauf.
Ein SatzLänge und Auflösung setzen, dann generieren
Kauf zuerst die Sekunden, die die Zeile braucht. Zurück kommt eine MP4 mit Sprache, Raumton und Mundbewegung schon darin.
Bis zu 1080P
Rund neunzig Sekunden für einen kurzen Clip, und du kannst den Tab schließen, während er läuft. Das hochgeladene Foto wird nie verändert — die Ausgabe ist eine neue Datei.
Dein Foto ist Frame eins.
Die Stimme wird geschrieben, nicht hochgeladen.
Die meisten Werkzeuge dieser Art nehmen ein Bild und eine Audiodatei und bewegen den Mund passend dazu. Dieses nimmt ein Bild und einen Satz.

Frame 001 · dein Gesicht
Ab hier gesprochen und synchronisiert
KI-Lippensynchronisation mit Wan 3.0 setzt dein Foto buchstäblich als ersten Frame ein und generiert von dort 2 bis 30 Sekunden nach vorn, bei 30 fps in 480P, 720P oder 1080P. Die Worte, die du zitiert hast, kommen als Sprache in der eigenen Tonspur dieses Clips zurück, und der Mund bewegt sich dazu, weil Bild und Ton im selben Durchlauf gerendert werden statt in zweien zusammengenäht.
- Dein Foto ist Frame eins
- 001
- Audiodateien, die du liefern musst
- 0
- Jede ganze Sekunde
- 2–30 s
- MP4 zurück, Ton schon darin
- 1
Dein Foto ist Frame eins
Audiodateien, die du liefern musst
Jede ganze Sekunde
MP4 zurück, Ton schon darin
- Kein Text-zu-Sprache-Schritt vor dem Rendern
- Kein Synchronisationsdurchgang danach
- Kein zweites Modell, das man für den Mund lizenzieren müsste
Was entscheidet, ob eine Zeile gesprochen
oder quer übers Bild gedruckt wird
Zwei Sätze entscheiden, ob eine Zeile gehört oder gelesen wird. Der eine legt die genauen Worte in den Mund der sprechenden Person; der andere hält sie aus dem Bild. Lass einen davon weg, und der Fehlschlag kommt als fertiges, abgerechnetes Video an.
Die Anatomie einer synchronen Zeile
Sprache und Bild · ein Durchlauf
Zehn Runden · 720P · 30 sWas der Mund braucht, um zu sitzen
3
- Die genauen Worte, zitiert statt zusammengefasst
- Eine sprechende Person, genau genug beschrieben, um sie festzulegen
- Die Kamera auf ihrem Gesicht, während sie spricht
Die Regel, die alle übersehen
Es gibt kein Feld für Negativ-Prompts, „das hier nicht drucken“ ist also ein Satz im Prompt wie jeder andere. Lass ihn weg, und das Modell darf deinen Dialog als etwas behandeln, das es zusätzlich zum Sprechen auch ins Bild zeichnet — und genau deshalb endet Alibabas eigene Dreißig-Sekunden-Demo, oben abgedruckt, auf exakt dieser Anweisung.
no subtitles, no text overlaysRichtigNegative prompt: subtitlesFalsch
Alles, was wie ein Negativ-Prompt aussieht, wird als weitere zu rendernde Worte gelesen, und die Anfrage läuft trotzdem durch — der Fehlschlag kommt also als fertiger Clip an, mit der Beschriftung „Negative prompt“ irgendwo im Bild.
Geschweifte Klammern gehen auch — {like this} ist das, was die Prompt-Werkzeuge dieser Website ausgeben. Worauf das Modell wirklich achtet, ist eine abgegrenzte Zeile mit einer sichtbar zugeordneten sprechenden Person, und Alibabas eigene veröffentlichte Prompts benutzen dafür Anführungszeichen. Text zu Video behandelt die vier Tonebenen und die Reihenfolge, in der man sie benennt.
Prüf das Porträt,
bevor du einen Credit ausgibst
Ein Gesicht, das Wan 3.0 nicht lesen kann, ist der ärgerlichste Weg, eine Generierung zu verlieren, denn du erfährst es nach der Warteschlange statt davor. Leg das Foto hier ab, und es wird gegen die echten Grenzen geprüft — Format, Größe, Maße, Verhältnis und Transparenz — mit der Lösung neben der Zeile, die durchfällt. Nichts wird hochgeladen: Die Prüfung läuft in deinem Browser.
JPG · JPEG · PNG · BMP · WEBP · ≤20.0 MB · 240–8,000px · ratio ≤8:1
Ein Gesicht, so gerahmt, dass der Mund nicht das Kleinste im Bild ist, gibt der Synchronität am meisten zum Arbeiten. Die Prüfung rührt das Modell nie an, ein Porträt, das ohnehin nicht gelesen worden wäre, kostet also nichts an Erkenntnis.
Grenzen der Wan-3.0-Lippensynchronisation
— Porträt, Clip und Stimme
Fünf dieser Zeilen regeln das Foto, zwei regeln, was herauskommt, und die letzte ist die, die eine Ablehnung produziert, mit der niemand rechnet. Das Uploadfeld oben auf dieser Seite prüft die Bildzeilen, bevor du etwas ausgibst.
Ein festgelegter erster Frame und eine Sprachaufnahme können nicht zusammen reisen. Frames sind die eine Eingabefamilie und Referenzen die andere; eine Anfrage, die beide trägt, wird rundheraus abgelehnt statt heruntergestuft — die Entscheidung fällt also vor dem Hochladen.
Die Zeile selbst hat kein eigenes Feld und keine eigene Grenze: Sie steht mit allem anderen im Prompt, und der fasst 20.000 Zeichen. Was eine gesprochene Zeile begrenzt, ist die Uhr, nicht die Zeichenzahl — etwa zwei bis drei Sekunden Bildzeit pro kurzem Satz, eine Zeile mit fünfzehn Wörtern in einem Clip von vier Sekunden wird also entweder gehetzt oder abgeschnitten. Kauf die Sekunden, die die Zeile braucht, bevor du die Auflösung kaufst.
Was ein Clip mit Wan-3.0-Lippensynchronisation kostet
Länge und Auflösung setzen den Preis. Sprache nicht: Der Tonschalter ändert, was zurückkommt, nicht was es kostet, und eine Stimmreferenz wird gar nicht abgerechnet. Ein fehlgeschlagener Durchlauf wird automatisch erstattet, und die Prüfung oben hält die meisten vermeidbaren Fehlschläge von vornherein vom Modell fern.
So wird abgerechnet
- Abgerechnet nach
- Ausgabesekunde
- Sprache, Stimmreferenz
- ohne Berechnung
- Dein erster Clip
- kostenlos · 480P
Arbeite die Zeile in 480P durch, bis die Sprechweise sitzt, und gib dann einen Durchlauf für 720P oder 1080P aus — das Porträt muss zwischen den Durchläufen nicht neu geprüft werden. Alle Preise.
So oder so dieselben Credits pro Monat
Wan-3.0-Lippensynchronisation — die Fragen, mit denen Leute wirklich ankommen
Die, die sich vor dem Hochladen eines Gesichts zu beantworten lohnen, mit Zahlen aus Alibabas eigener Parametertabelle statt aus einer Funktionsliste.
Brauche ich eine Audiodatei für die Lippensynchronisation?
She says: "Two minutes to set up." — und Wan 3.0 generiert die Sprache selbst, im selben Durchlauf wie das Bild, mit dem Mund passend dazu. Ein Foto und ein Satz sind die ganze Eingabe. Eine Sprachaufnahme ist der andere Weg, für den Fall, dass die Klangfarbe eine bestimmte sein muss.Wie schreibe ich die Zeile, damit sie gesprochen und nicht beschrieben wird?
She says: "…", dann die Sprechweise. Worte, die nur zusammengefasst sind, werden stattdessen erzählt oder erfunden. Die Prompt-Werkzeuge dieser Website setzen Zeilen in geschweifte Klammern, {like this}, was dieselbe Aufgabe erfüllt: zu markieren, wo die Zeile anfängt und aufhört.Meine Zeile kam auf dem Bildschirm gedruckt an statt gesprochen. Warum?
Negative prompt: subtitles zu schreiben bewirkt das Gegenteil: Diese Worte werden zu etwas, das gezeichnet wird.Kann ich mein Foto und meine Sprachaufnahme zusammen hochladen?
Wie lang darf die Zeile sein?
In welchen Sprachen funktioniert die Lippensynchronisation?
Können zwei Personen im selben Clip sprechen?
Kostet die Sprache extra?
Bleibt der Rest des Bildes still, während gesprochen wird?
Wessen Gesicht und wessen Stimme darf ich verwenden?
Darf ich einen sprechenden Clip kommerziell veröffentlichen?
Ein Gesicht, ein Satz
Lade das Porträt hoch, zitier die Zeile, die gesagt werden soll, und hör, was zurückkommt. Ein kostenloser Wan 3.0-Clip in 480P, bis zu drei Sekunden — eine E-Mail, keine Karte. Ist die Sprechweise nicht die, die du dir vorgestellt hast, hat sie dich nichts gekostet.
Geschrieben und gepflegt von der Redaktion von wan-3.runVeröffentlicht am Zuletzt aktualisiert am Tool Version 2026.09.4