Wan 3.0 Vídeo con Sincronización Labial
Suelta una cara, cita la frase y la boca sigue a las palabras. Wan 3.0 sincronización labial genera la voz en la misma pasada que la imagen, así que no hay archivo de audio que grabar antes ni pasada de doblaje después. De dos a treinta segundos, sonido dentro del MP4, y tu primer clip es gratis.
Las propias demos de diálogo de Wan 3.0 de Alibaba · Probar esto carga el prompt
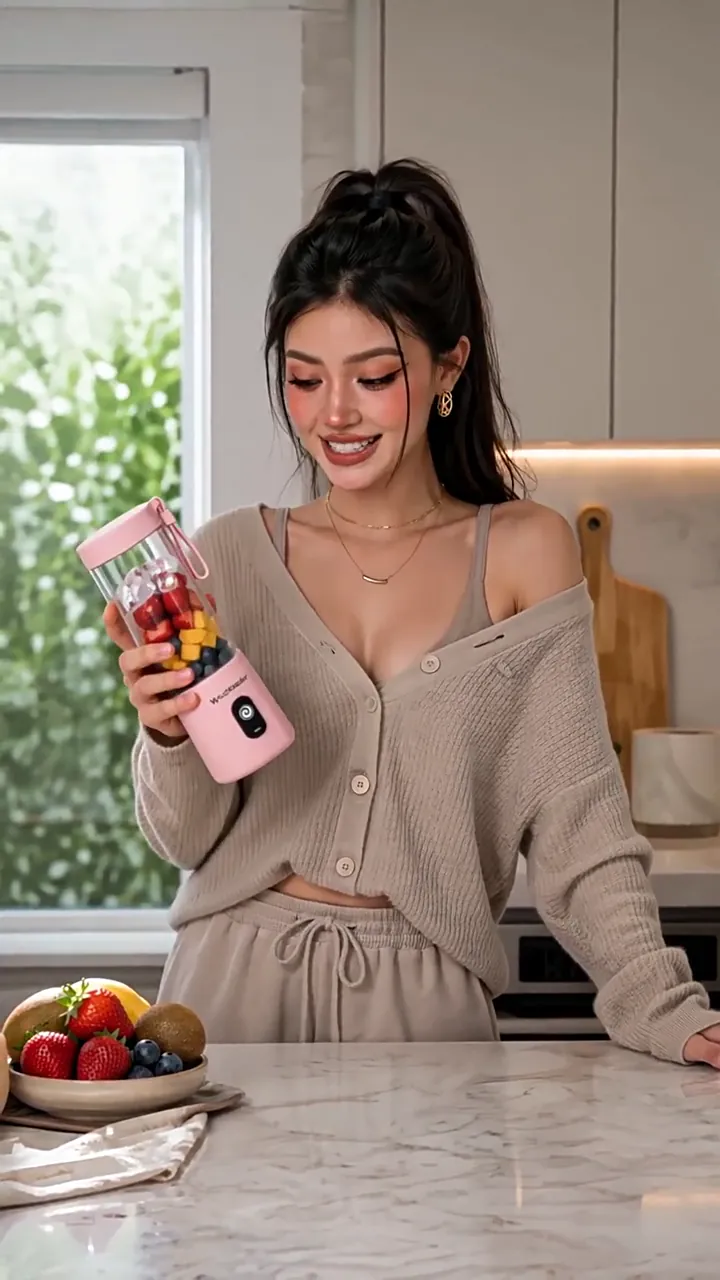
 HABLADO A CÁMARA · 9:16 · 720P
Una pieza a cámara, de seis frases
Qué hace Wan 3.0 cuando el prompt lleva una frase dentro
Todos los clips de aquí son demos que Alibaba publicó para Wan 3.0, y cada uno llegó con el prompt que lo produjo. Pulsa Escúchalo para la voz, o Usar prompt para cargarlo entero en la casilla de arriba de esta página: impreso completo y en el idioma en que se escribió.
- 1 pasadaimagen, voz y movimiento de boca en una sola generación
- $0de más por la pista de audio
- wan3.0-videoel modelo detrás de cada clip de esta banda
- ReferenciaSeis frases a cámara, con el producto sostenido por una imagen de referencia
 ReferenciaUna cantante cambiando de idioma, con la sincronización aguantando en los ocho
 ReferenciaDos hablantes, en japonés, una frase cada uno y sin solaparse
 Primer fotogramaUna imagen fija de dos animales se convierte en diez rondas de diálogo
- Las palabras
Cita la frase exacta. Una paráfrasis te da una frase que se inventó el modelo.
- Hablante
Fija quién habla — edad, pelo, ropa — o se moverá la boca equivocada.
- Cámara
Mantenla en la cara durante toda la frase.
- Texto
Cierra con sin subtítulos, o la frase puede llegar impresa sobre el encuadre.
Genera vídeo con sincronización labial por IA desde prompts de texto sencillos
Sin formato de guion, sin línea de tiempo y sin archivo de voz. Describe el plano en frases corrientes, cita las palabras que dice el personaje y atribúyeselas a la persona que sale en cámara, y Wan 3.0 renderiza la imagen, sintetiza la voz y le mueve la boca en una sola petición.
Plano medio principal. La mujer está detrás de la encimera de la cocina
sosteniendo la batidora portátil rosa, hablando con naturalidad a cámara.
Ella dice: «Me preguntan mucho cómo hago los batidos tan rápido.»
Sin subtítulos, sin rótulos, sin interfaz, sin marca de agua.
- Plano, cámara y quién habla
- La frase citada, y qué no imprimir
9:16 · 720P · 30Swan3.0-video · 16:9 · 720P · 14s · voz y boca en la misma pasada
Esas cuatro líneas están sacadas de la propia demo de treinta segundos de Alibaba, que ocupa 2 484 caracteres frente a un techo de 20 000. El espacio es para fijar al hablante, el producto y las exclusiones, no para escribir más. Subir un retrato en lugar de describir uno no cambia nada de cómo se escribe la frase.
Mejora el prompt de tu vídeo con sincronización labial
con IA
Una ejecución que vuelve mal casi nunca es un problema del modelo. Es un prompt que nombró la imagen y dejó al azar la interpretación, la cámara y la regla de los subtítulos.
El generador de prompts toma la frase que quieres que se diga y devuelve un prompt completo de Wan 3.0 construido a su alrededor: el hablante fijado, un movimiento de cámara nombrado, las capas de audio ordenadas y la frase delimitada para que se interprete en lugar de narrarse. Comprueba el resultado contra las reglas que este modelo impone de verdad, así que la cláusula que la gente olvida se añade antes de gastar el crédito y no después.
01
Escribe la frase que necesitas que se diga
Con una frase basta para empezar. Quién la dice y dónde puede ser un fragmento.
02
Recibe un prompt construido a su alrededor
Hablante, cámara, capas de sonido y la frase delimitada, en el orden en que las lee Wan 3.0.
03
Envíalo aquí y añade la cara
El prompt llega a la casilla de arriba de esta página con la duración y la relación ya puestas.
¿Estás escribiendo la frase para un anuncio de pago y no para una pieza a cámara? El generador de anuncios UGC tiene el número de palabras que aguantan de verdad quince segundos, y las normas de divulgación que deciden si se puede emitir.
¿Ya tienes un clip cuya interpretación te gustó? Vídeo a prompt transcribe la frase hablada y te la devuelve entre llaves: la forma que este modelo interpreta en lugar de narrar.
Un flujo de trabajo con IA completo, del guion al vídeo
Cuatro puertas al mismo endpoint. Tengas lo que tengas — un párrafo de guion, una presentación, un retrato o un clip que ya renderizaste —, hay una ruta desde ahí hasta una toma hablada, y ninguna necesita una herramienta de voz aparte atornillada al lado.


Todo lo de arriba aterriza en el mismo sitio: mis creaciones guarda el MP4, el prompt y el ID de tarea de cada ejecución, así que una toma que te gustó se puede volver a abrir en lugar de reconstruirla.
Cómo sincronizar los labios de una foto
con Wan 3.0
El paso que la gente hace mal es el tercero: describir la imagen que el modelo ya ve, en lugar de escribir las palabras que no puede adivinar.
Suelta la cara
La comprobación es instantánea y ocurre en tu navegador. Un archivo bueno muestra una fila verde; uno malo nombra la solución antes de que gastes nada.
Comprobado gratisCita la frase, y di quién la dice
Las palabras exactas entre comillas, atribuidas a la persona que sale en cámara. Una paráfrasis — «ella dice algo tranquilizador» — te da una frase que se inventó el modelo.
Solo palabras exactasCierra con «sin subtítulos»
No hay campo de prompt negativo, así que la instrucción de no imprimir la frase es una frase como las demás. Es una cláusula y salva una ejecución entera.
Una cláusulaFija duración y resolución, y genera
Compra primero los segundos que necesita la frase. Vuelve un solo MP4 con la voz, el sonido de sala y el movimiento de boca ya dentro.
Hasta 1080P
Alrededor de noventa segundos para un clip corto, y puedes cerrar la pestaña mientras se ejecuta. La fotografía subida no se modifica nunca: la salida es un archivo nuevo.
Tu fotografía es el fotograma uno.
La voz se escribe, no se sube.
Casi todas las herramientas de esta categoría admiten una imagen y un archivo de audio y mueven la boca para que encaje. Esta admite una imagen y una frase.

Fotograma 001 · tu cara
Hablado, y sincronizado, de aquí en adelante
Wan 3.0 sincronización labial mete tu fotografía como primer fotograma literal y genera de 2 a 30 segundos hacia delante desde ahí, a 30 fps en 480P, 720P o 1080P. Las palabras que citaste vuelven como voz en la propia pista de audio de ese clip, con la boca moviéndose con ellas, porque la imagen y el sonido se renderizan en la misma pasada en lugar de coserse en dos.
- Tu foto es el fotograma uno
- 001
- Archivos de audio que tienes que aportar
- 0
- Cualquier segundo entero
- 2–30 s
- Un MP4 de vuelta, con el sonido ya dentro
- 1
Tu foto es el fotograma uno
Archivos de audio que tienes que aportar
Cualquier segundo entero
Un MP4 de vuelta, con el sonido ya dentro
- Sin paso de texto a voz antes del render
- Sin pasada de doblaje después
- Sin un segundo modelo que licenciar para la boca
Qué decide si una frase se habla
o se imprime sobre el encuadre
Dos frases deciden si una línea se oye o se lee. Una pone las palabras exactas en boca del hablante; la otra las mantiene fuera de la imagen. Deja cualquiera de las dos fuera y el fallo llega como vídeo terminado y facturado.
La anatomía de una frase sincronizada
Voz e imagen · una pasada
Diez rondas · 720P · 30sLo que necesita la boca para cuadrar
3
- Las palabras exactas, citadas en lugar de resumidas
- Un hablante descrito con la precisión suficiente para fijarlo
- La cámara en su cara mientras habla
La regla que se le escapa a la gente
No hay campo de prompt negativo, así que «no imprimas esto» es una frase del prompt como cualquier otra. Déjala fuera y el modelo es libre de tratar tu diálogo como algo que renderizar en pantalla además de hablarlo, y por eso la propia demo de treinta segundos de Alibaba, impresa arriba, termina con esa instrucción exacta.
sin subtítulos, sin rótulosBienPrompt negativo: subtítulosMal
Cualquier cosa con forma de prompt negativo se lee como más palabras que renderizar, y la petición se completa igual, así que el fallo llega como un clip terminado con la etiqueta «Negative prompt» en algún lugar del encuadre.
Las llaves también valen: {like this} es lo que emiten las herramientas de prompts de este sitio. Lo que el modelo busca en realidad es una frase delimitada con un hablante visible atado a ella, y los prompts publicados por la propia Alibaba usan comillas para eso. Texto a vídeo cubre las cuatro capas de sonido y el orden en que nombrarlas.
Comprueba el retrato
antes de gastar un crédito
Una cara que Wan 3.0 no va a leer es la forma más molesta de perder una generación, porque te enteras después de la cola y no antes. Suelta aquí la fotografía y se comprueba contra los límites reales — formato, tamaño, dimensiones, relación y transparencia — con la solución nombrada para la fila que falle. No se sube nada: la comprobación se ejecuta en tu navegador.
JPG · JPEG · PNG · BMP · WEBP · ≤20.0 MB · 240–8,000px · ratio ≤8:1
Una sola cara, encuadrada de modo que la boca no sea lo más pequeño de la imagen, le da a la sincronización con lo que trabajar. El comprobador nunca toca el modelo, así que averiguar que un retrato no iba a poder leerse no cuesta nada.
Límites de Wan 3.0 sincronización labial
— el retrato, el clip y la voz
Cinco de estas filas gobiernan la fotografía, dos gobiernan lo que sale, y la última es la que produce un rechazo que nadie espera. La casilla de subida de arriba comprueba las filas de imagen antes de que gastes nada.
Un primer fotograma fijado y una grabación de voz no pueden viajar juntos. Los fotogramas son una familia de entradas y las referencias son la otra; una petición que lleve las dos se rechaza sin más en lugar de degradarse, así que la elección ocurre antes de subir nada.
La frase en sí no tiene campo aparte ni límite aparte: vive en el prompt con todo lo demás, y el prompt admite 20 000 caracteres. Lo que limita una frase hablada es el reloj, no el recuento de caracteres: alrededor de dos o tres segundos de pantalla por frase corta, así que una frase de quince palabras en un clip de cuatro segundos sale atropellada o se corta. Compra los segundos que necesita la frase antes de comprar la resolución.
Lo que cuesta un clip de Wan 3.0 sincronización labial
La duración y la resolución fijan el precio. La voz no: el interruptor de audio cambia lo que vuelve, no lo que cuesta, y una referencia de voz no se cobra en absoluto. Una ejecución fallida se reembolsa automáticamente, y el comprobador de arriba mantiene la mayoría de los fallos evitables lejos del modelo desde el principio.
Cómo se cobra esto
- Se cobra por
- segundo de salida
- Voz, referencia de voz
- sin cargo
- Tu primer clip
- gratis · 480P
Boceta la frase en 480P hasta que la interpretación cuadre y después gasta una ejecución en 720P o 1080P: el retrato no hay que volver a comprobarlo entre ejecuciones. Precios completos.
Los mismos créditos al mes en ambos casos
Wan 3.0 sincronización labial: las preguntas con las que la gente llega de verdad
Las que merece la pena responder antes de subir una cara, con las cifras tomadas de la propia tabla de parámetros de Alibaba y no de una lista de funciones.
¿Necesito un archivo de audio para tener sincronización labial?
She says: "Two minutes to set up." — y Wan 3.0 genera la voz él mismo, en la misma pasada que la imagen y con la boca moviéndose con ella. Una fotografía y una frase son toda la entrada. Una grabación de voz es la otra vía, para cuando el timbre tiene que ser uno concreto.¿Cómo escribo la frase para que se hable en lugar de describirse?
She says: "…", y después la interpretación. Las palabras que solo se resumen acaban narradas o inventadas. Las herramientas de prompts de este sitio envuelven las frases entre llaves, {like this}, que hace el mismo trabajo de marcar dónde empieza y dónde acaba la frase.Mi frase salió impresa en pantalla en lugar de hablada. ¿Por qué?
Negative prompt: subtitles hace lo contrario: esas palabras se convierten en algo que dibujar.¿Puedo subir mi foto y mi grabación de voz a la vez?
¿Cuánto puede durar la frase?
¿En qué idiomas funciona la sincronización labial?
¿Pueden hablar dos personas en el mismo clip?
¿La voz cuesta más?
¿El resto de la imagen se queda quieta mientras habla?
¿Qué cara y qué voz puedo usar?
¿Puedo publicar comercialmente un clip hablado?
Una cara, una frase
Sube el retrato, cita la frase que necesitas que se diga y escucha lo que vuelve. Un clip gratis de Wan 3.0 en 480P, hasta tres segundos: un correo, sin tarjeta. Si la interpretación no es la que imaginabas, no te ha costado nada.
Escrito y mantenido por el equipo editorial de wan-3.runPublicado el Actualizado el Herramienta versión 2026.09.4