Wan 3.0 リップシンク動画
顔を放り込んで台詞を引用符で書けば、口が言葉についてきます。Wan 3.0 のリップシンクは音声を絵と同じパスで生成するので、先に録る音声ファイルも、あとから当てる吹き替えのパスも要りません。2 秒から 30 秒、音は MP4 の中に、そして最初の 1 本は料金がかかりません。
アリババ自身の Wan 3.0 セリフデモ · 「試す」でプロンプトが読み込まれます
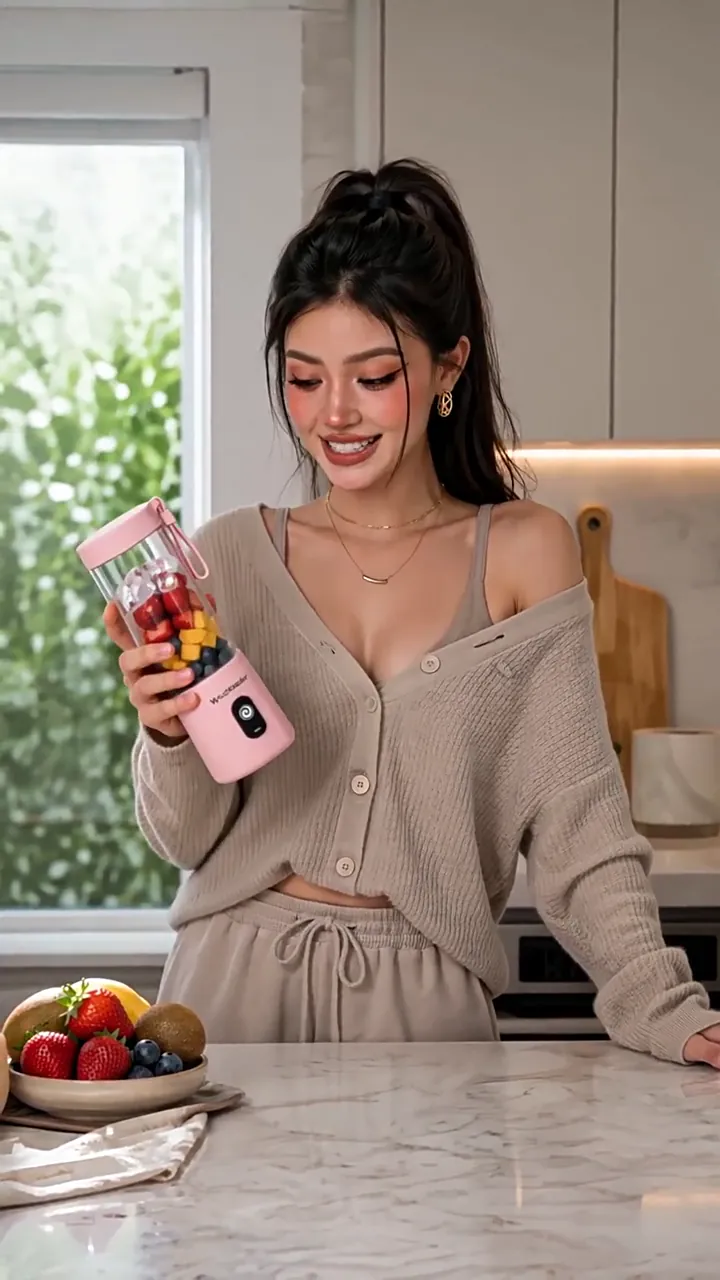
 カメラに向かって · 9:16 · 720P
カメラに向かって、台詞 6 つぶん
プロンプトに 台詞が入っているとき、Wan 3.0 は何をするか
ここにあるクリップはすべてアリババが Wan 3.0 のために公開したデモで、どれも生成したプロンプト付きで公開されました。聴くで音声を、プロンプトを使うでこのページ上部の入力欄に丸ごと読み込めます — 書かれた言語のまま、省略なしで載せています。
- 1 パス絵、発話、口の動きが 1 回の生成の中に
- $0音声トラックの追加料金
- wan3.0-videoこの帯のすべてのクリップを作ったモデル
- リファレンスカメラに向かって 6 つの台詞、商品はリファレンス画像に固定
 リファレンス言語を切り替え続ける歌手 1 人、同期は 8 言語すべてで保たれています
 リファレンス話し手 2 人、日本語、1 人 1 台詞、かぶりなし
 先頭フレーム動物 2 匹の静止画が、10 往復の会話になります
- 言葉
台詞そのものを引用してください。言い換えると、モデルが作った台詞が返ってきます。
- 話し手
誰が話すかを固定 — 年齢、髪、服装。でないと違う口が動きます。
- カメラ
台詞のあいだは顔に寄せたままにしてください。
- 文字
字幕なしで締めてください。でないと台詞が画面に印字されて返ることがあります。
かんたんなテキストプロンプトから AI リップシンク動画を生成
台本の書式も、タイムラインも、音声ファイルも要りません。ふつうの文でショットを説明し、キャラクターが言う言葉を引用符で書いて画面の人物に紐づければ、Wan 3.0 が 1 リクエストの中で絵を生成し、音声を合成し、口をそれに合わせて動かします。
Medium A-roll. The woman stands behind the kitchen counter
holding the pink portable blender, speaking naturally to camera.
She says: "I get asked how I make smoothies so quickly."
No subtitles, no text overlays, no UI, no watermark.
- ショット、カメラ、そして誰が話しているか
- 引用された台詞と、印字してほしくないもの
9:16 · 720P · 30Swan3.0-video · 16:9 · 720P · 14 秒 · 発話と口の動きが同じパスで
上の 4 行はアリババ自身の 30 秒デモから抜いたもので、そのプロンプトは 20,000 文字の上限に対して 2,484 文字です。余白は話し手と商品と除外事項を固定するためにあり、長く書くためではありません。 ポートレートをアップロードするか文章で描写するかで、台詞そのものの書き方は何も変わりません。
リップシンク動画のプロンプトを
AI でよくする
外して返ってきた生成は、まずモデルの問題ではありません。絵は名指ししたのに、言い回し・カメラ・字幕の扱いを運任せにしたプロンプトです。
プロンプトジェネレーターは、言わせたい台詞を受け取って、その周りに完成した Wan 3.0 のプロンプトを返します — 話し手を固定し、カメラの動きを 1 つ名指しし、音のレイヤーに順位をつけ、台詞をナレーションではなく演技として読ませるために区切ってあります。結果はこのモデルが実際に強制する規則と照合されるので、人が忘れがちな一文は、クレジットを使ったあとではなく使う前に足されます。
01
言わせたい台詞を打つ
始めるには 1 文で十分です。誰がどこで言うかは断片でかまいません。
02
その周りにプロンプトを組んでもらう
話し手、カメラ、音のレイヤー、区切った台詞を、Wan 3.0 が読む順番で。
03
ここへ送って顔を足す
プロンプトはこのページ上部の入力欄に、尺と比率をすでに設定した状態で届きます。
言い回しが気に入ったクリップがすでにありますか? 動画からプロンプトが話された台詞を書き起こし、波かっこに入れて返します — このモデルがナレーションではなく演技として扱う形です。
台本から動画までの、ひと続きの AI ワークフロー
同じエンドポイントへの入口が 4 つ。手元にあるのが台本の一段落でも、企画書でも、ポートレートでも、すでに生成したクリップでも、そこからしゃべるテイクまでの道があります。どれにも、別の音声ツールを後付けする必要はありません。


上のすべては同じ場所に着きます — マイ作品が、どの生成についても MP4・プロンプト・タスク ID を保管するので、気に入ったテイクは組み立て直すのではなく開き直せます。
Wan 3.0 で
写真にリップシンクさせる手順
人が間違えるのは 3 つ目です。モデルにはもう見えている絵を説明してしまい、モデルには推測できない言葉のほうを書かない。
顔を放り込む
チェックはブラウザ内で即座に走ります。良いファイルは緑の行、悪いファイルは何も使う前に直し方を教えてくれます。
チェックは無料台詞を引用し、誰が言うかを書く
そのままの言葉を引用符で、画面の人物に紐づけて。言い換え —「彼女が何か安心させることを言う」— では、モデルが作った台詞が返ってきます。
そのままの言葉だけ「字幕なし」で締める
ネガティブプロンプトの欄はないので、台詞を印字するなという指示もほかと同じ 1 文です。一節で済み、生成 1 回ぶんを救います。
一節尺と解像度を決めて、生成
台詞に必要な秒数を先に買ってください。発話・部屋鳴り・口の動きがすでに入った MP4 が 1 本返ってきます。
1080P まで
短いクリップで 90 秒ほど。走っているあいだタブを閉じてかまいません。アップロードした写真が変更されることはありません — 出力は新しいファイルです。
あなたの写真が 1 フレーム目です。
音声はアップロードするのではなく、書きます。
このカテゴリのたいていの道具は、画像と音声ファイルを取って口をそれに合わせます。これは画像と 1 つの文を取ります。

フレーム 001 · あなたの顔
ここから先は、しゃべって、同期して
Wan 3.0 のリップシンクは、あなたの写真を文字どおりの先頭フレームとして入れ、そこから 30 fps・480P / 720P / 1080P で 2〜30 秒を前へ生成します。引用した言葉は、そのクリップ自身の音声トラックに発話として返り、口はそれに合わせて動きます。絵と音が 2 回に分けて縫い合わされるのではなく、同じパスで生成されるからです。
- あなたの写真が 1 フレーム目
- 001
- 用意すべき音声ファイルの数
- 0
- 任意の整数秒
- 2〜30 秒
- 返ってくる MP4。音はすでに中に
- 1
あなたの写真が 1 フレーム目
用意すべき音声ファイルの数
任意の整数秒
返ってくる MP4。音はすでに中に
- 生成前のテキスト読み上げ工程なし
- 生成後の吹き替えパスなし
- 口のために別のモデルをライセンスする必要なし
台詞がしゃべられるか、
画面に印字されるかを決めるもの
2 つの文が、台詞が聞こえるか読まれるかを決めます。片方はそのままの言葉を話し手の口に入れ、もう片方はそれを絵の上から遠ざけます。どちらかを落とすと、失敗は完成した課金済みの動画として届きます。
同期する台詞の解剖図
発話と絵 · 1 パス
10 往復 · 720P · 30 秒口が決まるために要るもの
3
- 要約ではなく引用された、そのままの言葉
- 固定できるだけ具体的に書かれた話し手
- 話しているあいだ、その顔に向いたカメラ
人が見落とす規則
ネガティブプロンプトの欄はないので、「これを印字するな」もほかと同じくプロンプトの中の 1 文です。落とせばモデルは、あなたの台詞を**しゃべるものであると同時に画面に描くもの**として扱ってよいことになります。上に全文を載せたアリババ自身の 30 秒デモが、まさにその指示で終わっているのはそのためです。
no subtitles, no text overlays正Negative prompt: subtitles誤
ネガティブプロンプトの形をしたものは**描くべき言葉が増えた**と読まれ、しかもリクエストは成功します — なので失敗は、画面のどこかに「ネガティブプロンプト」という文字が入った完成クリップとして届きます。
波かっこでも働きます — {like this} はこのサイトのプロンプトツールが出す形で、上の壁にある洗面所のクリップもそれで生成されています。モデルが実際に探しているのは話し手が見える形で紐づいた、区切られた台詞で、アリババの公開プロンプトは引用符を使っています。テキストから動画が、4 つの音のレイヤーと名指しする順番を扱っています。
クレジットを使う前に
ポートレートを確認
Wan 3.0 が読めない顔は、生成を失う一番いらだたしい形です。待ち行列の前ではなく、あとで分かるからです。ここに写真をドロップすれば、本物の上限 — 形式、サイズ、寸法、比率、透過 — と照合され、落ちた行ごとに直し方が示されます。何もアップロードされません。チェックはブラウザ内で走ります。
JPG · JPEG · PNG · BMP · WEBP · ≤20.0 MB · 240–8,000px · ratio ≤8:1
顔 1 つ、しかも口が画面でいちばん小さいものにならない画角なら、同期に使える手がかりが最大になります。チェッカーはモデルに一切触れないので、どのみち読まれなかったポートレートを見つけるのに費用はかかりません。
Wan 3.0 リップシンクの上限
— ポートレート、クリップ、音声
このうち 5 行は写真を、2 行は出てくるものを規定し、最後の 1 行が誰も予想しない拒否を生みます。このページ上部のアップロード欄が、画像の行を使う前に確認します。
固定した先頭フレームと音声の録音は、一緒に旅できません。 フレームは入力の一族、リファレンスはもう一族で、両方を持つリクエストは格下げではなくその場で拒否されます。だから選択はアップロードの前に起きます。
台詞そのものに専用の欄も専用の上限もありません。ほかのすべてと一緒にプロンプトの中に住み、プロンプトは 20,000 文字を抱えます。話される台詞を縛るのは文字数ではなく時計です — 短い 1 文につき画面上でおよそ 2〜3 秒なので、15 語の台詞を 4 秒のクリップに入れれば、早口になるか途中で切れるかです。解像度を買う前に、台詞に必要な秒数を買ってください。
Wan 3.0 リップシンク 1 本の費用
値段を決めるのは尺と解像度です。発話は決めません:音声のスイッチが変えるのは返ってくるものであって、値段ではありませんし、音声リファレンスはそもそも課金されません。失敗した生成は自動で返金されますし、上のチェッカーが避けられる失敗のほとんどを、そもそもモデルに近づけません。
課金のされ方
- 課金単位
- 出力 1 秒
- 発話、音声リファレンス
- 課金なし
- 最初の 1 本
- 無料 · 480P
言い回しが決まるまで 480P で下書きし、それから 720P か 1080P で 1 回だけ使ってください — 生成のあいだにポートレートを確認し直す必要はありません。料金の全体。
どちらでも月々のクレジットは同じ
Wan 3.0 リップシンク — 実際に持ち込まれる質問
顔をアップロードする前に答えておく価値のあるものだけ。数値は機能一覧ではなく、アリババ自身のパラメータ表から取っています。
リップシンクに音声ファイルは必要ですか
She says: "Two minutes to set up." — Wan 3.0 が絵と同じパスで自分で発話を生成し、口をそれに合わせて動かします。写真 1 枚と 1 つの文が入力の全部です。音声の録音はもう一方の経路で、声質が特定のものでなければならないときのためのものです。説明されるのではなく、しゃべられる台詞はどう書きますか
She says: "…"、それから言い回し。要約しただけの言葉はナレーションされるか、作られるかです。 このサイトのプロンプトツールは台詞を波かっこ {like this} で包みますが、これも台詞の始まりと終わりを示すという同じ仕事をしています。台詞がしゃべられずに画面に印字されて出ました。なぜですか
Negative prompt: subtitles と書くのは逆効果で、その言葉自体が描くべきものになります。写真と自分の音声の録音を一緒にアップロードできますか
台詞はどれくらい長くできますか
リップシンクはどの言語で働きますか
同じクリップの中で 2 人が話せますか
発話には追加料金がかかりますか
話しているあいだ、画面の残りは静止したままですか
誰の顔と誰の声なら使ってよいのですか
しゃべるクリップを商用で公開できますか
顔 1 つ、文 1 つ
ポートレートをアップロードして、言わせたい台詞を引用符で書いて、返ってくるものを聴いてみてください。Wan 3.0 のクリップ 1 本が 480P・3 秒まで無料 — メールのみ、カード不要。想像した言い回しでなかったとしても、費用はかかっていません。
wan-3.run 編集チームが執筆・管理しています公開 最終更新 ツール バージョン 2026.09.4