Synchronisation labiale IA Wan 3.0
Déposez un visage, citez la réplique, et la bouche suit les mots. La synchronisation labiale de Wan 3.0 génère la voix dans la même passe que l’image : aucun fichier audio à enregistrer avant, aucune passe de doublage après. De deux à trente secondes, le son dans le MP4, et votre premier clip est offert.
Les démos de dialogue Wan 3.0 publiées par Alibaba · Essayer charge le prompt
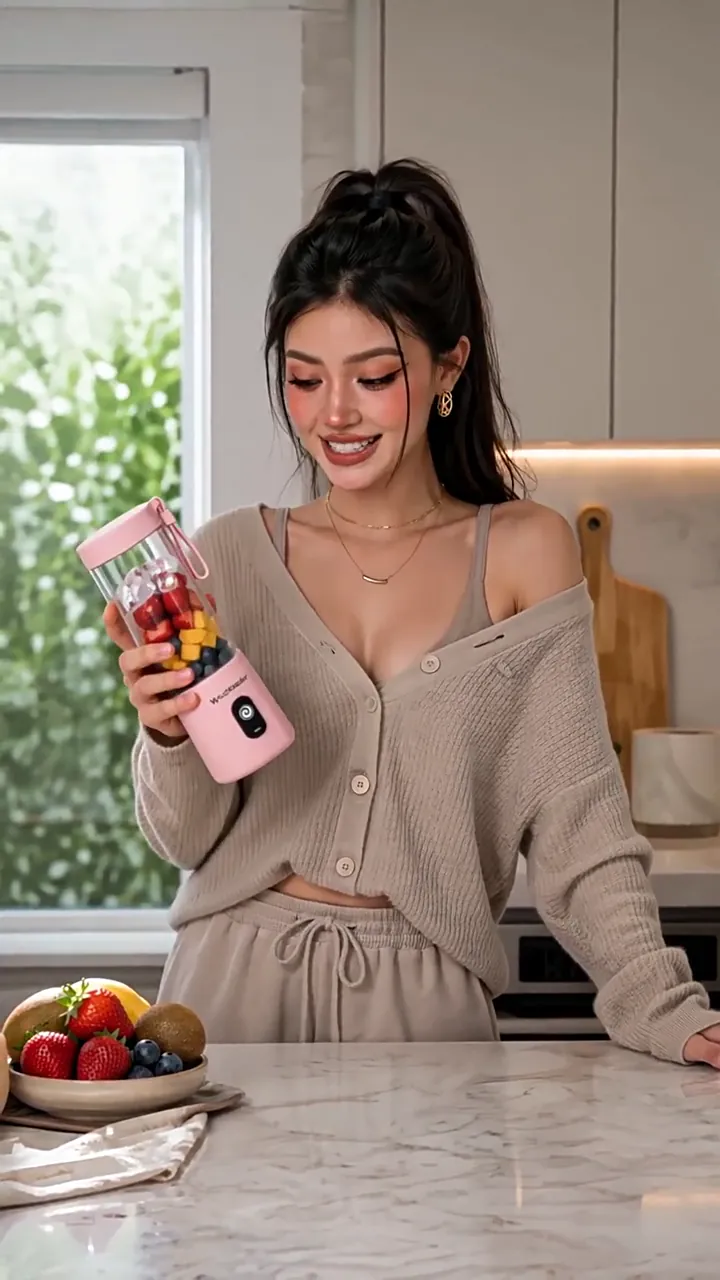
 PARLÉ FACE CAMÉRA · 9:16 · 720P
Un face caméra de six répliques
Ce que fait Wan 3.0 quand le prompt contient une réplique
Chaque clip ici est une démo publiée par Alibaba pour Wan 3.0, et chacune est arrivée avec le prompt qui l’a produite. Appuyez sur Écouter pour la voix, ou sur Utiliser le prompt pour charger l’ensemble dans la zone en haut de cette page — publié en entier, dans la langue où il a été écrit.
- 1 passeimage, parole et mouvement des lèvres en une seule génération
- $0de supplément pour la piste audio
- wan3.0-videole modèle derrière chaque clip de ce bandeau
- RéférenceSix répliques face caméra, le produit tenu par une image de référence
 RéférenceUne chanteuse qui change de langue, la synchronisation tenant sur les huit
 RéférenceDeux locuteurs, en japonais, une réplique chacun et aucun chevauchement
 Première imageUne image fixe de deux animaux devient dix tours de dialogue
- Les mots
Citez la réplique exacte. Une paraphrase donne une réplique inventée par le modèle.
- Locuteur
Fixez qui parle — âge, cheveux, vêtements — sinon c’est la mauvaise bouche qui bouge.
- Caméra
Gardez-la sur le visage pendant toute la réplique.
- Texte
Terminez par pas de sous-titres, sinon la réplique peut arriver écrite sur l’image.
Générer une vidéo en synchronisation labiale à partir de phrases simples
Aucun format de scénario, aucune ligne de temps, aucun fichier de voix. Décrivez le plan en phrases ordinaires, citez les mots que dit le personnage en les lui attribuant, et Wan 3.0 dessine l’image, synthétise la voix et y accorde la bouche en une seule requête.
Medium A-roll. The woman stands behind the kitchen counter
holding the pink portable blender, speaking naturally to camera.
She says: "I get asked how I make smoothies so quickly."
No subtitles, no text overlays, no UI, no watermark.
- Le plan, la caméra, et qui parle
- La réplique citée, et ce qu’il ne faut pas imprimer
9:16 · 720P · 30 swan3.0-video · 16:9 · 720P · 14 s · parole et bouche dans la même passe
Ces quatre lignes sont tirées de la démo de trente secondes d’Alibaba, qui fait 2 484 caractères pour un plafond de 20 000. La place est là pour fixer le locuteur, le produit et les exclusions — pas pour écrire davantage. Téléverser un portrait au lieu d’en décrire un ne change rien à la façon d’écrire la réplique.
Améliorez votre prompt de synchronisation labiale
avec l’IA
Un lancement qui revient raté n’est presque jamais un problème de modèle. C’est un prompt qui a nommé l’image et laissé au hasard l’intention, la caméra et la règle sur les sous-titres.
Le générateur de prompts prend la réplique que vous voulez entendre et renvoie un prompt Wan 3.0 complet autour d’elle — locuteur fixé, un seul mouvement de caméra nommé, les couches sonores hiérarchisées, et la réplique délimitée pour qu’elle soit jouée plutôt que narrée. Il confronte le résultat aux règles que ce modèle applique vraiment : la clause qu’on oublie est ajoutée avant que le crédit ne parte, pas après.
01
Tapez la réplique dont vous avez besoin
Une phrase suffit pour commencer. Qui la dit et où, cela peut tenir en un fragment.
02
Récupérez un prompt bâti autour d’elle
Locuteur, caméra, couches sonores et réplique délimitée, dans l’ordre où Wan 3.0 les lit.
03
Envoyez-le ici et ajoutez le visage
Le prompt arrive dans la zone en haut de cette page, avec la durée et le format déjà réglés.
Ouvrir le générateur de prompts
Vous avez déjà un clip dont l’intention vous plaisait ? Vidéo vers prompt transcrit la réplique et vous la rend entre accolades — la forme que ce modèle joue au lieu de narrer.
Un enchaînement complet, du script à la vidéo
Quatre portes vers le même point d’accès. Quoi que vous ayez sous la main — un paragraphe de script, une présentation, un portrait ou un clip déjà calculé — il existe un chemin vers une prise parlée, et aucun d’eux ne demande d’ajouter un outil de voix à côté.


Tout ce qui précède atterrit au même endroit — mes créations conserve le MP4, le prompt et l’identifiant de tâche de chaque lancement : une prise qui vous a plu se rouvre au lieu de se reconstituer.
Comment faire parler une photo
avec Wan 3.0
L’étape que les gens ratent est la troisième : décrire l’image que le modèle voit déjà, au lieu d’écrire les mots qu’il ne peut pas deviner.
Déposez le visage
La vérification est immédiate, dans votre navigateur. Un bon fichier affiche une ligne verte ; un mauvais nomme la correction avant que vous ne dépensiez quoi que ce soit.
Vérification offerteCitez la réplique, et dites qui la dit
Les mots exacts entre guillemets, attribués à la personne à l’écran. Une paraphrase — « elle dit quelque chose de rassurant » — vous donne une réplique inventée par le modèle.
Les mots exacts, uniquementTerminez par « pas de sous-titres »
Il n’y a pas de champ de prompt négatif : l’instruction de ne pas imprimer la réplique est donc une phrase comme les autres. C’est une seule proposition, et elle sauve un lancement entier.
Une propositionRéglez la durée et la résolution, puis générez
Achetez d’abord les secondes dont la réplique a besoin. Un seul MP4 revient, avec la parole, l’ambiance et le mouvement des lèvres déjà dedans.
Jusqu’au 1080P
Environ quatre-vingt-dix secondes pour un clip court, et vous pouvez fermer l’onglet pendant que ça tourne. La photographie téléversée n’est jamais modifiée — la sortie est un nouveau fichier.
Votre photographie est l’image un.
La voix s’écrit, elle ne se téléverse pas.
La plupart des outils de cette catégorie prennent une photo et un fichier audio, puis font bouger la bouche pour correspondre. Celui-ci prend une photo et une phrase.

Image 001 · votre visage
Parlé, et synchronisé, à partir d’ici
La synchronisation labiale de Wan 3.0 place votre photographie comme première image au sens littéral et génère 2 à 30 secondes vers l’avant, à 30 fps en 480P, 720P ou 1080P. Les mots que vous avez cités reviennent en parole dans la piste audio de ce clip, avec la bouche qui les suit, parce que l’image et le son sont calculés dans la même passe plutôt que recousus en deux.
- Votre photo est l’image un
- 001
- Fichiers audio que vous devez fournir
- 0
- N’importe quelle seconde entière
- 2–30 s
- Un MP4 en retour, le son déjà dedans
- 1
Votre photo est l’image un
Fichiers audio que vous devez fournir
N’importe quelle seconde entière
Un MP4 en retour, le son déjà dedans
- Aucune étape de synthèse vocale avant le calcul
- Aucune passe de doublage après
- Aucun second modèle à licencier pour la bouche
Ce qui décide qu’une réplique est dite
ou imprimée en travers de l’image
Deux phrases décident si une réplique est entendue ou lue. L’une met les mots exacts dans la bouche du locuteur ; l’autre les garde hors de l’image. Oubliez l’une des deux et l’échec arrive sous forme de vidéo finie et facturée.
L’anatomie d’une réplique synchronisée
Parole et image · une seule passe
Dix tours · 720P · 30 sCe qu’il faut à la bouche pour tomber juste
3
- Les mots exacts, cités plutôt que résumés
- Un locuteur décrit d’assez près pour être fixé
- La caméra sur son visage pendant qu’il parle
La règle qu’on oublie
Il n’y a pas de champ de prompt négatif : « ne pas imprimer ceci » est donc une phrase du prompt comme une autre. Omettez-la et le modèle est en droit de traiter votre dialogue comme quelque chose à dessiner à l’écran en plus de le dire — c’est pourquoi la démo de trente secondes d’Alibaba, publiée plus haut, se termine exactement sur cette instruction.
no subtitles, no text overlaysJusteNegative prompt: subtitlesFaux
Tout ce qui a la forme d’un prompt négatif est lu comme des mots de plus à dessiner, et la requête aboutit quand même — l’échec arrive donc sous forme de clip fini avec la mention « Negative prompt » quelque part dans l’image.
Les accolades marchent aussi — {like this} est ce qu’émettent les outils de prompt de ce site. Ce que le modèle cherche vraiment, c’est une réplique délimitée avec un locuteur visible attaché, et les prompts publiés par Alibaba utilisent les guillemets pour cela. Texte vers vidéo couvre les quatre couches sonores et l’ordre dans lequel les nommer.
Vérifiez le portrait
avant de dépenser un crédit
Un visage que Wan 3.0 ne saura pas lire est la façon la plus agaçante de perdre une génération, parce que vous l’apprenez après la file d’attente et non avant. Déposez la photographie ici et elle est confrontée aux vraies limites — format, poids, dimensions, proportions et transparence — avec la correction nommée pour la ligne qui échoue. Rien n’est téléversé : la vérification tourne dans votre navigateur.
JPG · JPEG · PNG · BMP · WEBP · ≤20.0 MB · 240–8,000px · ratio ≤8:1
Un seul visage, cadré pour que la bouche ne soit pas le plus petit élément de l’image, donne à la synchronisation le plus de matière. Le vérificateur ne touche jamais au modèle : un portrait qui n’avait aucune chance d’être lu ne coûte rien à identifier.
Les limites de la synchronisation labiale
— le portrait, le clip et la voix
Cinq de ces lignes gouvernent la photographie, deux gouvernent ce qui sort, et la dernière est celle qui produit un refus que personne n’attend. La zone de téléversement en haut de cette page contrôle les lignes d’image avant que vous ne dépensiez quoi que ce soit.
Une première image verrouillée et un enregistrement de voix ne peuvent pas voyager ensemble. Les images d’ouverture sont une famille d’entrées et les références en sont une autre ; une requête qui porte les deux est refusée tout net plutôt que rétrogradée, si bien que le choix se fait avant le téléversement.
- Format du portrait
- JPEG · JPG · PNG · BMP · WEBPLe HEIC est refusé — le conteneur par défaut de l’iPhone n’est pas sur la liste
- Officiel
- Format d’image
- 8:1 – 1:8Une plage, pas un plafond — une colonne en 1:9 est refusée comme une bannière en 9:1
- Officiel
- Durée du clip
- 2 – 30 s à 30 fpsN’importe quel nombre entier de secondes, en 480P, 720P ou 1080P
- Officiel
- Référence vocale
- 5 pistes · ≤ 15 s au totalWAV ou MP3, jusqu’à 15 Mo chacune, 1–15 s par piste
- Officiel
La réplique elle-même n’a ni champ ni limite à part : elle vit dans le prompt avec tout le reste, et le prompt tient 20 000 caractères. Ce qui contraint une réplique parlée, c’est l’horloge, pas le nombre de caractères — environ deux à trois secondes d’écran par phrase courte, si bien qu’une réplique de quinze mots dans un clip de quatre secondes est soit précipitée, soit coupée. Achetez les secondes dont la réplique a besoin avant d’acheter la résolution.
Ce que coûte un clip en synchronisation labiale Wan 3.0
La durée et la résolution fixent le prix. La parole, non : l’interrupteur audio change ce qui revient, pas ce que ça coûte, et une référence vocale n’est pas facturée du tout. Un lancement raté est remboursé automatiquement, et le vérificateur ci-dessus tient l’essentiel des échecs évitables à l’écart du modèle dès le départ.
Comment c’est facturé
- Facturé à la
- seconde produite
- Parole, référence vocale
- sans frais
- Votre premier clip
- offert · 480P
Faites tourner la réplique en 480P jusqu’à ce que l’intention tombe juste, puis dépensez un lancement en 720P ou 1080P — le portrait n’a pas besoin d’être revérifié entre les deux. Tous les tarifs.
Les mêmes crédits mensuels dans les deux cas
Synchronisation labiale Wan 3.0 — les questions avec lesquelles on arrive vraiment
Celles qui méritent une réponse avant de téléverser un visage, avec les chiffres pris dans le tableau de paramètres d’Alibaba plutôt que sur une fiche produit.
Faut-il un fichier audio pour obtenir la synchronisation labiale ?
She says: "Two minutes to set up." — et Wan 3.0 génère lui-même la parole, dans la même passe que l’image, avec la bouche qui la suit. Une photographie et une phrase, c’est toute l’entrée. Un enregistrement de voix est l’autre voie, pour quand le timbre doit être un timbre précis.Comment écrire la réplique pour qu’elle soit dite plutôt que décrite ?
She says: "…", puis l’intention. Des mots seulement résumés se font narrer ou inventer. Les outils de prompt de ce site entourent les répliques d’accolades, {like this}, ce qui fait le même travail de marquer où la réplique commence et s’arrête.Ma réplique est sortie imprimée à l’écran au lieu d’être dite. Pourquoi ?
Negative prompt: subtitles fait l’inverse : ces mots deviennent quelque chose à dessiner.Puis-je téléverser ma photo et mon enregistrement de voix ensemble ?
Quelle longueur peut faire la réplique ?
Dans quelles langues la synchronisation labiale fonctionne-t-elle ?
Deux personnes peuvent-elles parler dans le même clip ?
La parole coûte-t-elle un supplément ?
Le reste de l’image reste-t-il immobile pendant qu’on parle ?
Quel visage et quelle voix ai-je le droit d’utiliser ?
Puis-je publier un clip parlé à des fins commerciales ?
Un visage, une phrase
Téléversez le portrait, citez la réplique que vous voulez entendre, et écoutez ce qui revient. Un clip Wan 3.0 offert en 480P, jusqu’à trois secondes — un e-mail, pas de carte. Si l’intention n’est pas celle que vous imaginiez, ça ne vous aura rien coûté.
Écrit et maintenu par l’équipe éditoriale de wan-3.runPublié le Mis à jour le Outil version 2026.09.4